“이거 그냥 AI가 다 써주는 거 아니야?”
블로그 자동화를 돌린다고 했더니 지인이 툭 던진 말이었다. 반박하려다 말문이 막혔다. 틀린 말은 아니니까. 초안은 진짜 AI가 뽑는다. 그런데 발행 버튼을 누르기 전까지, 나는 글 한 편에 한 시간 가까이 붙어 앉아 있다.
아니, 정확히는 — 다 맡기는 게 아니라 구간을 나누는 거였다. 이걸 늦게 깨달았다. 처음엔 “얼마나 자동화할 수 있나”만 봤는데, 어느 순간부터 “어디까지 맡기고 어디서부터 내가 손대나”로 질문이 바뀌었다. 웹기획할 때 화면 흐름을 단계로 쪼개 각 단계에 뭘 넣을지 정하던 버릇이, 하필 여기서 나왔다.
다 맡기는 게 아니라 구간을 나누는 일이었다
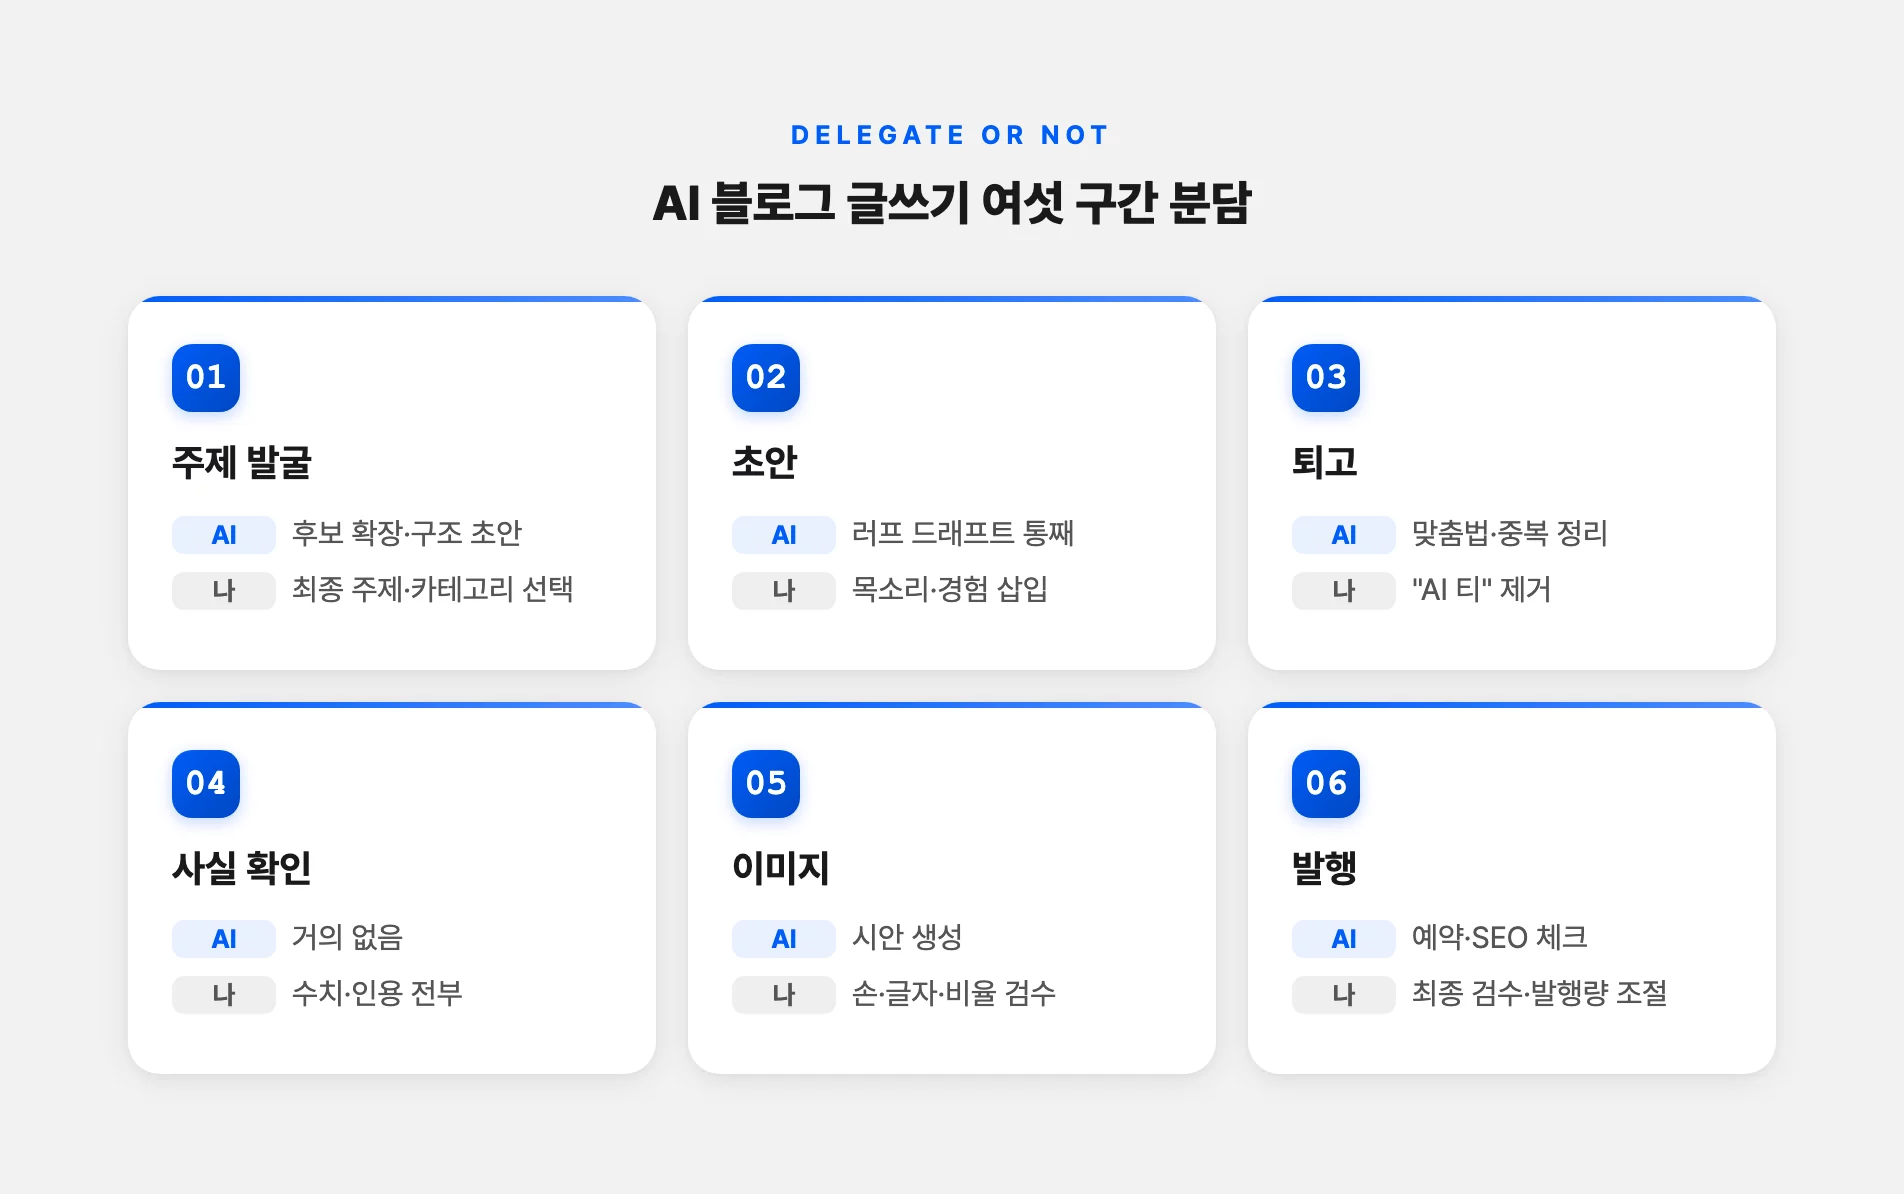
이 관점으로 바꾸고 나서 글쓰기가 여섯 토막으로 보이기 시작했다. 주제 발굴, 초안, 퇴고, 사실 확인, 이미지, 발행. 화면을 단계별로 자르듯 글도 단계별로 잘라놓으니, 어느 칸에 AI를 얼마나 부어도 되는지가 그제야 눈에 들어왔다.
한 자료에서 이걸 딱 한 문장으로 정리해둔 걸 봤다. AI를 최종 결과물이 아니라 “다시 다듬을 러프 드래프트 기계(rough-draft machine)”로 다뤄라. 러프 드래프트. 러프. 이 단어를 며칠 굴려봤는데, 볼수록 맞다. 초안 기계지 완성 기계가 아니라는 것. 그러니까 초안을 뽑는 칸에는 AI를 가득 부어도 되고, 그 초안을 내 것으로 만드는 칸은 내가 붙어 앉아야 한다는 뜻이었다.
여섯 칸을 놓고 보면 성격이 갈린다. 발행처럼 거의 통째로 맡겨도 되는 칸이 있고, 사실 확인처럼 절대 통으로 넘기면 안 되는 칸이 있다. 아래는 내가 실제로 파이프라인을 돌리며 나눠본 감각이다.
| 구간 | AI에 맡기는 정도 | 내가 손대는 부분 |
|---|---|---|
| 주제 발굴 | 후보 확장·구조 초안 | 최종 주제·카테고리 선택 |
| 초안 | 러프 드래프트 통째 | 목소리·경험 삽입 |
| 퇴고 | 맞춤법·중복 정리 | “AI 티” 제거 |
| 사실 확인 | 거의 없음 | 수치·인용 전부 |
| 이미지 | 시안 생성 | 손·글자·비율 검수 |
| 발행 | 예약·SEO 체크 | 최종 검수·발행량 조절 |
초안은 통째로 맡겨도, 결국 목소리에서 걸린다
초안 뽑는 건 정말 편하다. 소제목 뼈대, 문단 구조, 대략의 흐름까지 몇 초면 나온다. 여기까지는 손대고 싶은 마음도 안 든다. 문제는 그 다음이다.
여러 자료가 공통으로 지적하는 가장 큰 편집 병목이, 일반적인 AI 출력을 “실제로 나처럼 들리게” 다시 쓰는 일이라더라. 처음엔 이게 무슨 소린가 했는데, 초안을 몇 번 받아보니 알겠다. 문장은 다 맞는데 아무 냄새가 안 난다. 어느 블로그에 갖다 붙여도 통할 것 같은 문장. 그게 제일 무섭다.
그래서 나는 모든 문장을 안 고친다. 예전엔 처음부터 끝까지 갈아엎었는데, 따져보니 그건 시간 낭비였다. 도입부, 각 문단의 첫 문장, 그리고 “어느 회사에나 통할 법한 일반론”, 이 결정 지점만 골라서 다시 쓴다. 거기에 내 프로세스나 실제 겪은 사례 한두 개를 박아 넣는다.
퇴고는 입으로 읽어보면 걸리는 게 있다
퇴고 칸에서 AI가 잘하는 건 맞춤법이나 중복 표현 정리 같은 초벌 작업이다. 그건 맡겨도 된다. 대신 “AI 티”를 걷어내는 건 내 몫으로 남는다. 불필요하게 단서를 다는 문장, 지나치게 좌우 대칭이 맞는 구조, 뻔한 결론. 이런 게 걷어내야 할 것들이다.
내가 쓰는 방법은 단순하다. 소리 내어 읽는다. 도입부와 각 섹션의 첫 문장을 입으로 읽어보면 어색한 문장이 귀에 딱 걸린다. 눈으로 볼 때는 멀쩡하던 문장이, 소리로 나오면 매끈하다 못해 인공적으로 들린다. 그 문장만 다시 쓴다. 전부 고칠 필요도 없다.
숫자와 연구명은 일단 다 의심하고 못 찾으면 뺀다
여기가 내가 절대 AI에 통째로 안 넘기는 칸이다. 사실 확인.
할루시네이션이라는 말은 다들 들어봤을 거다. AI가 없는 걸 지어내고 그걸 사실인 양 내놓는 것. 펜실베이니아대 도서관 가이드에서 짚은 게 인상적이었는데, 이 도구들은 검색엔진이 아니라는 거다. 자료를 찾아보거나 출처를 확인하는 게 아니라, 이전에 본 패턴으로 답을 만들고, 못 만들면 그럴듯한 걸로 빈칸을 채운다. 읽고 나서야 왜 가짜 참고문헌이 슬쩍 끼는지 이해가 됐다.
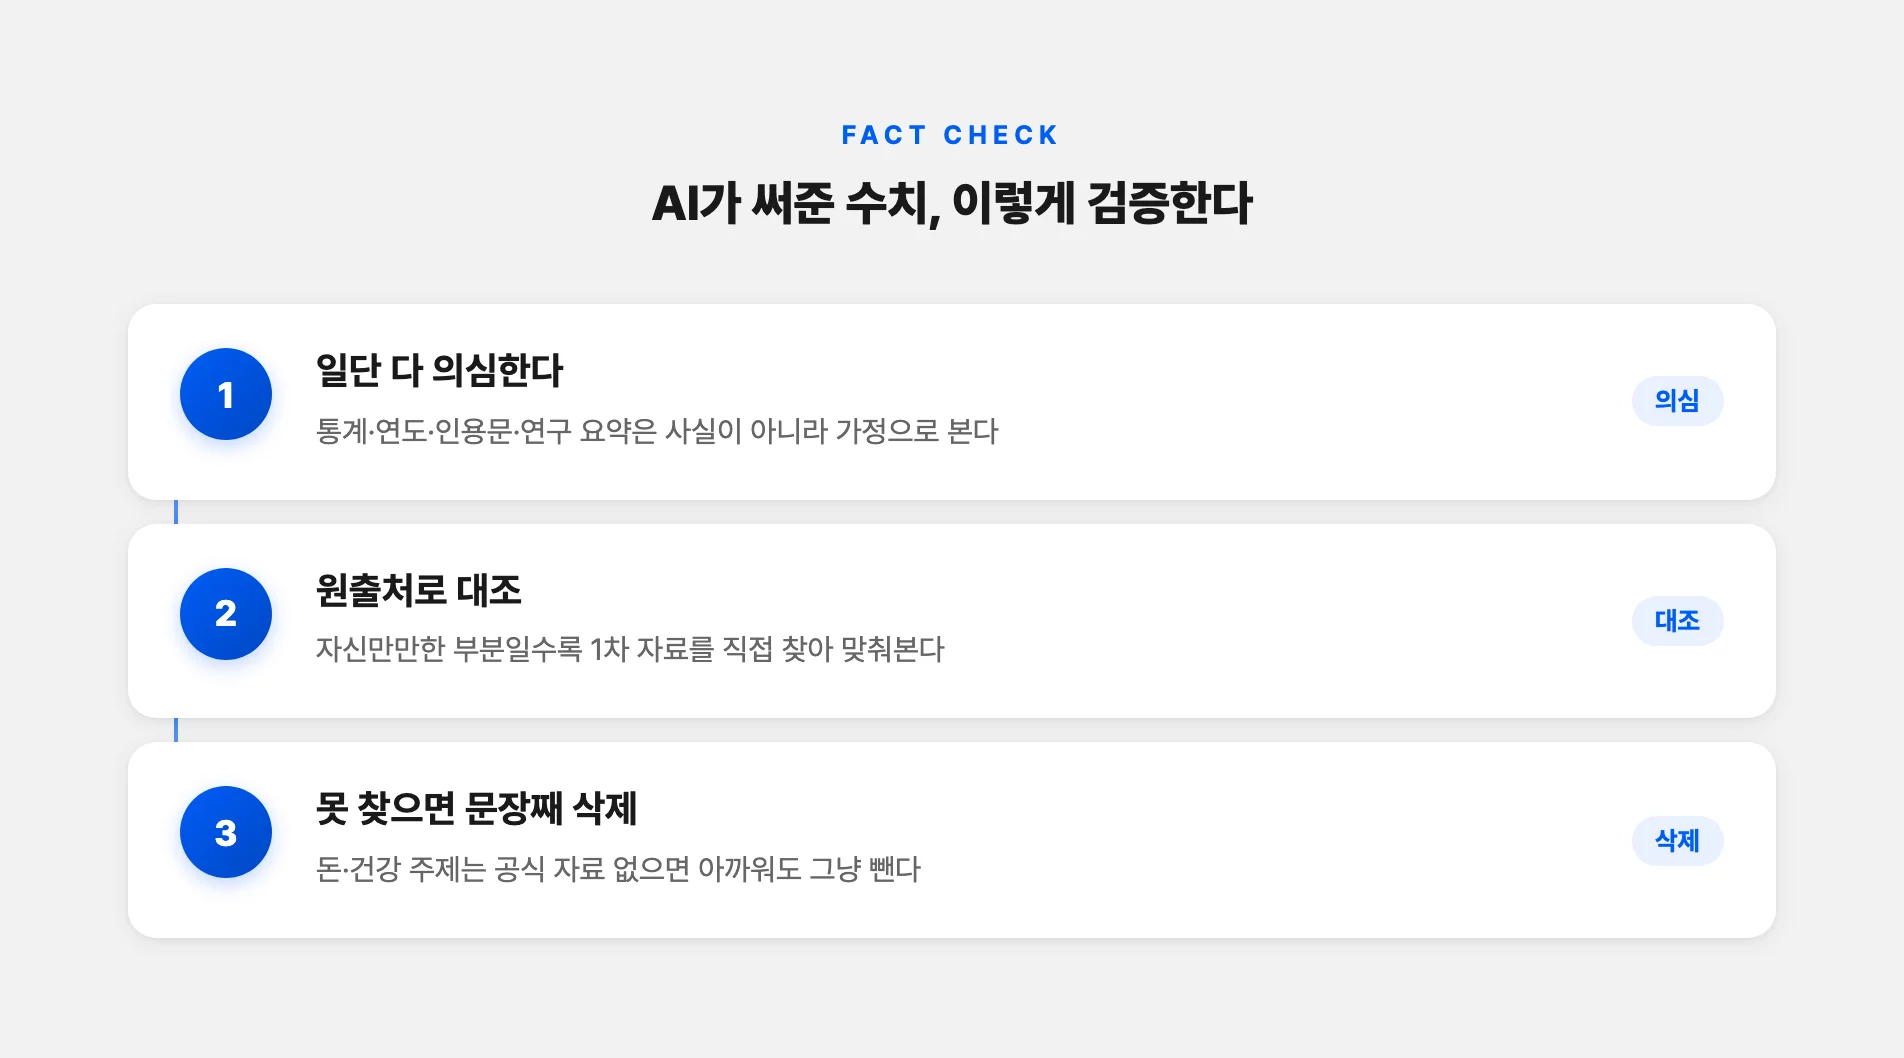
수치도 조심스럽다. 어떤 지적으로는 GPT-4가 학술 참고문헌을 만들 때 약 3분의 1가량 틀린 걸 내놓는다는 이야기가 있다. 이건 개별 매체가 인용한 수치라 나도 단정은 못 하겠고, 다만 “완벽하고 자신만만한 부분일수록 직접 찾아 확인하라”는 조언은 그냥 맞는 말이었다. 통계, 연도, 인용문, 연구 요약. 이 자리에 AI가 써준 건 일단 다 의심한다.
내 규칙은 단순해졌다. AI가 써준 숫자와 연구명은 원출처로 대조하고, 못 찾으면 문장째로 뺀다. 특히 돈이나 건강처럼 예민한 주제는 공식 1차 자료가 없으면 그냥 지운다. 아깝다고 남겨두면 그게 나중에 발목을 잡는다. 이 감각은 구글이 AI 콘텐츠를 두고 밝힌 입장과도 통한다. AI든 사람이든 벌주는 기준은 결국 품질이지 도구가 아니라는 것. 겉만 매끄럽고 알맹이 없는 글이 걸리는 거다.
이미지랑 발행은 맡기되, 손가락은 내가 센다
이미지도 시안까지는 AI가 뽑는다. 구도, 색감, 분위기. 그런데 손을 못 그린다. 이건 최신 모델도 여전한데, 손가락 개수가 틀리거나 관절이 뒤틀리거나 글자가 뜻 모를 형태로 깨진다. 손이 그림에서 작은 자리를 차지하면서도 구조가 복잡해서 그렇다더라. 그래서 시안이 나오면 나는 손가락부터 센다. 글자도 읽히는지 본다. 이상하면 그 부분만 다시 돌린다.
alt 텍스트도 사람이 다시 쓴다. 여기서 한 번 데인 적이 있어서다. 이미지 설명에 “인포그래픽”, “카드형” 같은 제작 지시어를 그대로 넣었더니, 구글 봇이 그 텍스트를 본문처럼 읽어버린다. 그게 그대로 AI 생성 신호가 되는 거다. 지금은 이미지를 못 본 독자한테 내용을 전할 수 있는 자연스러운 한국어 한 줄로 바꾼다.
발행은 오히려 가장 편한 칸이다. 예약 발행, SEO 체크리스트 정도는 거의 자동으로 돌아간다. 대신 발행량은 내가 조절한다. 하루에 몰아서 대량으로 찍어내면 그 패턴 자체가 신호가 되니까. 결국 자동화가 잘 굴러가는 건 사람이 검증하고 경험을 얹을 때라던데, 이건 정말 그렇더라.
쓰다 보니 이 글도 딱 그 순서를 밟았다. 초안은 맡기고, 여섯 칸으로 쪼개고, 숫자는 의심하고, 손가락은 내가 셌다. 근데 아직도 “AI 티” 걷어내는 건 매번 자신이 없다. 몇 문장은 지금도 어딘가 매끈해서, 내일 다시 읽으면 또 손댈 것 같다. 다 맡기는 날은 아마 안 오겠지.