“녹음만 던지면 회의록이 뚝딱 나온다며.” 후배가 이렇게 말했을 때 나는 애매하게 웃었다. 받아쓰기 AI를 몇 달 붙잡아본 사람 입장에서, 그 말은 맞기도 하고 아니기도 했다.
정확히는 이거다. 말이 글자로 바뀌는 건 정말 된다. 근데 그 글자를 실제 회의록이나 인터뷰 자료로 쓰려고 하면, 전사가 끝난 그 지점부터 진짜 일이 시작된다. 나도 처음엔 변환 버튼 누르고 커피 마시러 갔다가, 돌아와서 결과물 보고 한참 손봤다. 그 손보는 시간이 녹음 시간보다 길었던 적도 있다.
말이 글자로 바뀌는 건 절반일 뿐이더라
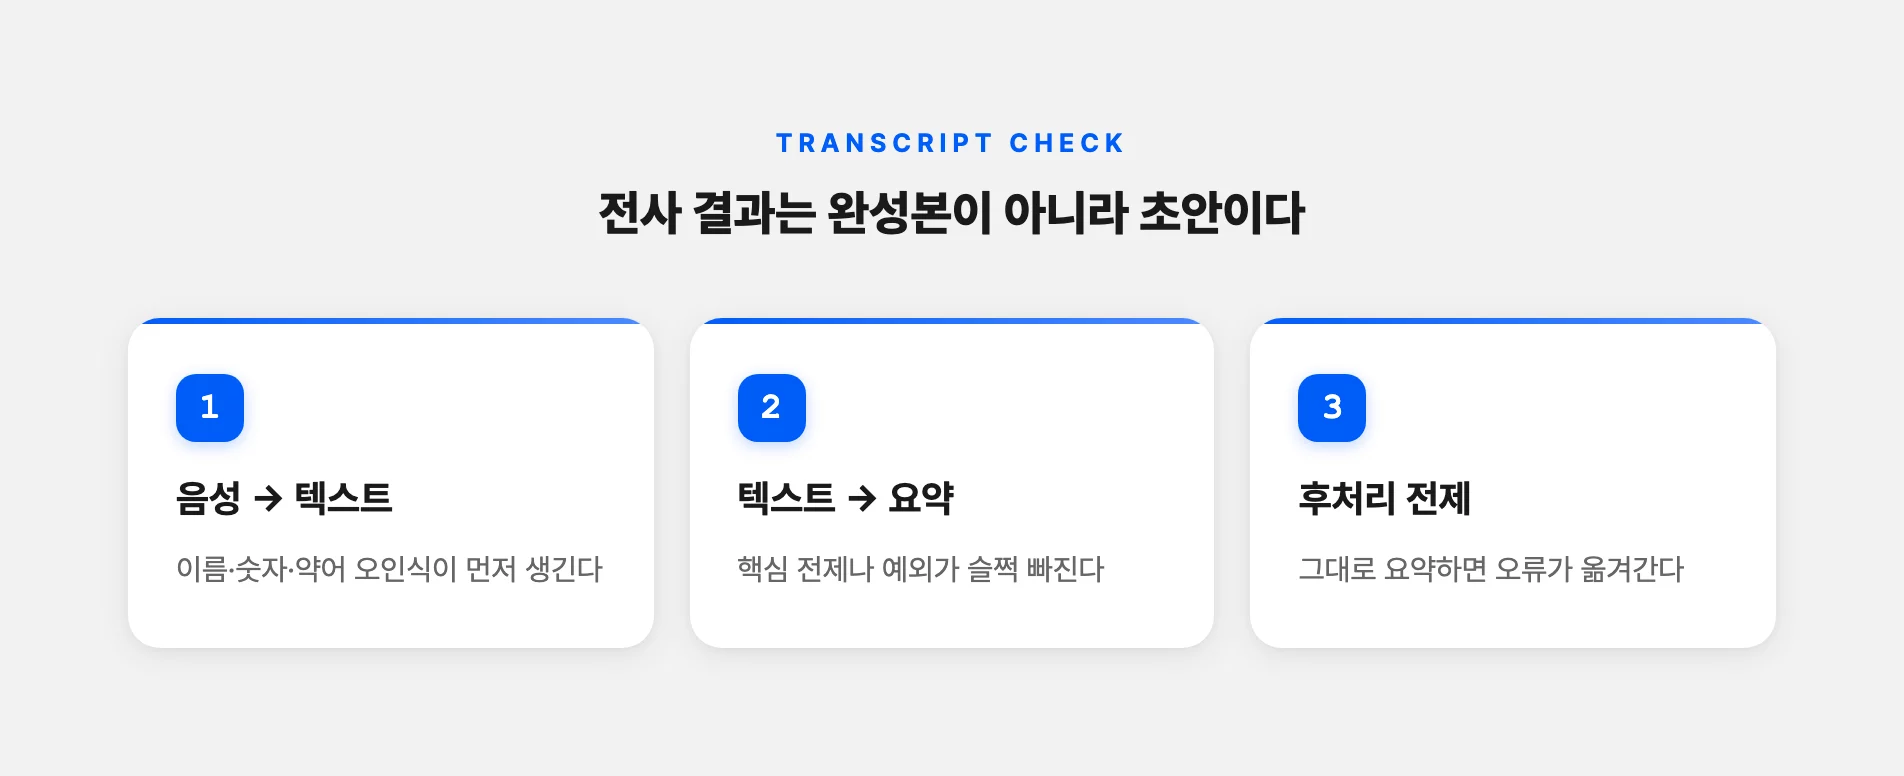
써보니 막히는 지점이 두 층으로 나뉘더라. 하나는 음성을 글자로 바꾸는 단계에서 나는 오타·오인식이고, 다른 하나는 그 텍스트를 AI한테 요약시킬 때 핵심을 놓치거나 없는 말을 지어내는 문제다.
이걸 나눠 보고 나서야 검수 지점이 잡혔다. SpeakNotes 같은 변환 서비스 안내를 보면, STT(음성→텍스트) 결과는 완성 문서가 아니라 후처리를 전제로 한 초안으로 보라고 한다. 처음엔 이 말이 좀 야박하게 들렸는데, 몇 번 데이고 나니 그게 맞았다. 전사문을 그대로 붙여넣고 “요약해줘” 하면 오류가 그대로 요약본에 옮겨간다.
가장 먼저 깨지는 건 이름이랑 숫자였다
내가 실제로 제일 많이 고친 건 회사명·사람 이름·업계 약어였다. 발음은 흔한데 표기가 정해진 단어들. 이게 통째로 틀리면 회의록 신뢰가 확 떨어진다.
유튜브 자동자막 사례가 이 성격을 잘 보여준다. 우리말studio 정리를 보면 ‘누리’가 ‘놀이’로, ‘휴가’가 ‘혀가’로 바뀌는 식이다. 순우리말이나 ‘습니다’→’읍니다’ 같은 맞춤법에도 약하다. 한국어에 특화된 서비스일수록 이런 오탈자가 적은 편이라는 비교글은 많지만, 클로바노트도 고유명사·외국어 이름은 여전히 놓친다는 지적이 반복된다. 그러니 이름 부분을 통째로 믿으면 안 된다.
우회법은 단순했다. 클로바·다글로에 있는 사용자 사전(키워드 사전) 기능에 회사명·자주 쓰는 용어·사람 이름을 미리 등록하는 거다. 등록한 단어에 한해서는 눈에 띄게 나아진다. 물론 등록 안 한 단어까지 알아서 맞춰주진 않는다. 그리고 숫자. 금액·날짜 같은 숫자는 발음이 짧고 앞뒤 문맥에 기대는 탓에 잘 틀린다. 그래서 나는 검수할 때 숫자와 고유명사부터 본다.
누가 말했나, 넷이 넘어가면 흔들린다
두 명이 주고받는 인터뷰는 화자 구분이 꽤 잘 됐다. 문제는 회의였다. 참석자가 네 명을 넘어가거나, 목소리 톤이 비슷하거나, 말이 겹치면 ‘화자1’과 ‘화자2’가 자꾸 섞였다. 여러 비교글에서도 참석자가 많아질수록 화자 오인식이 커진다고 짚는다.
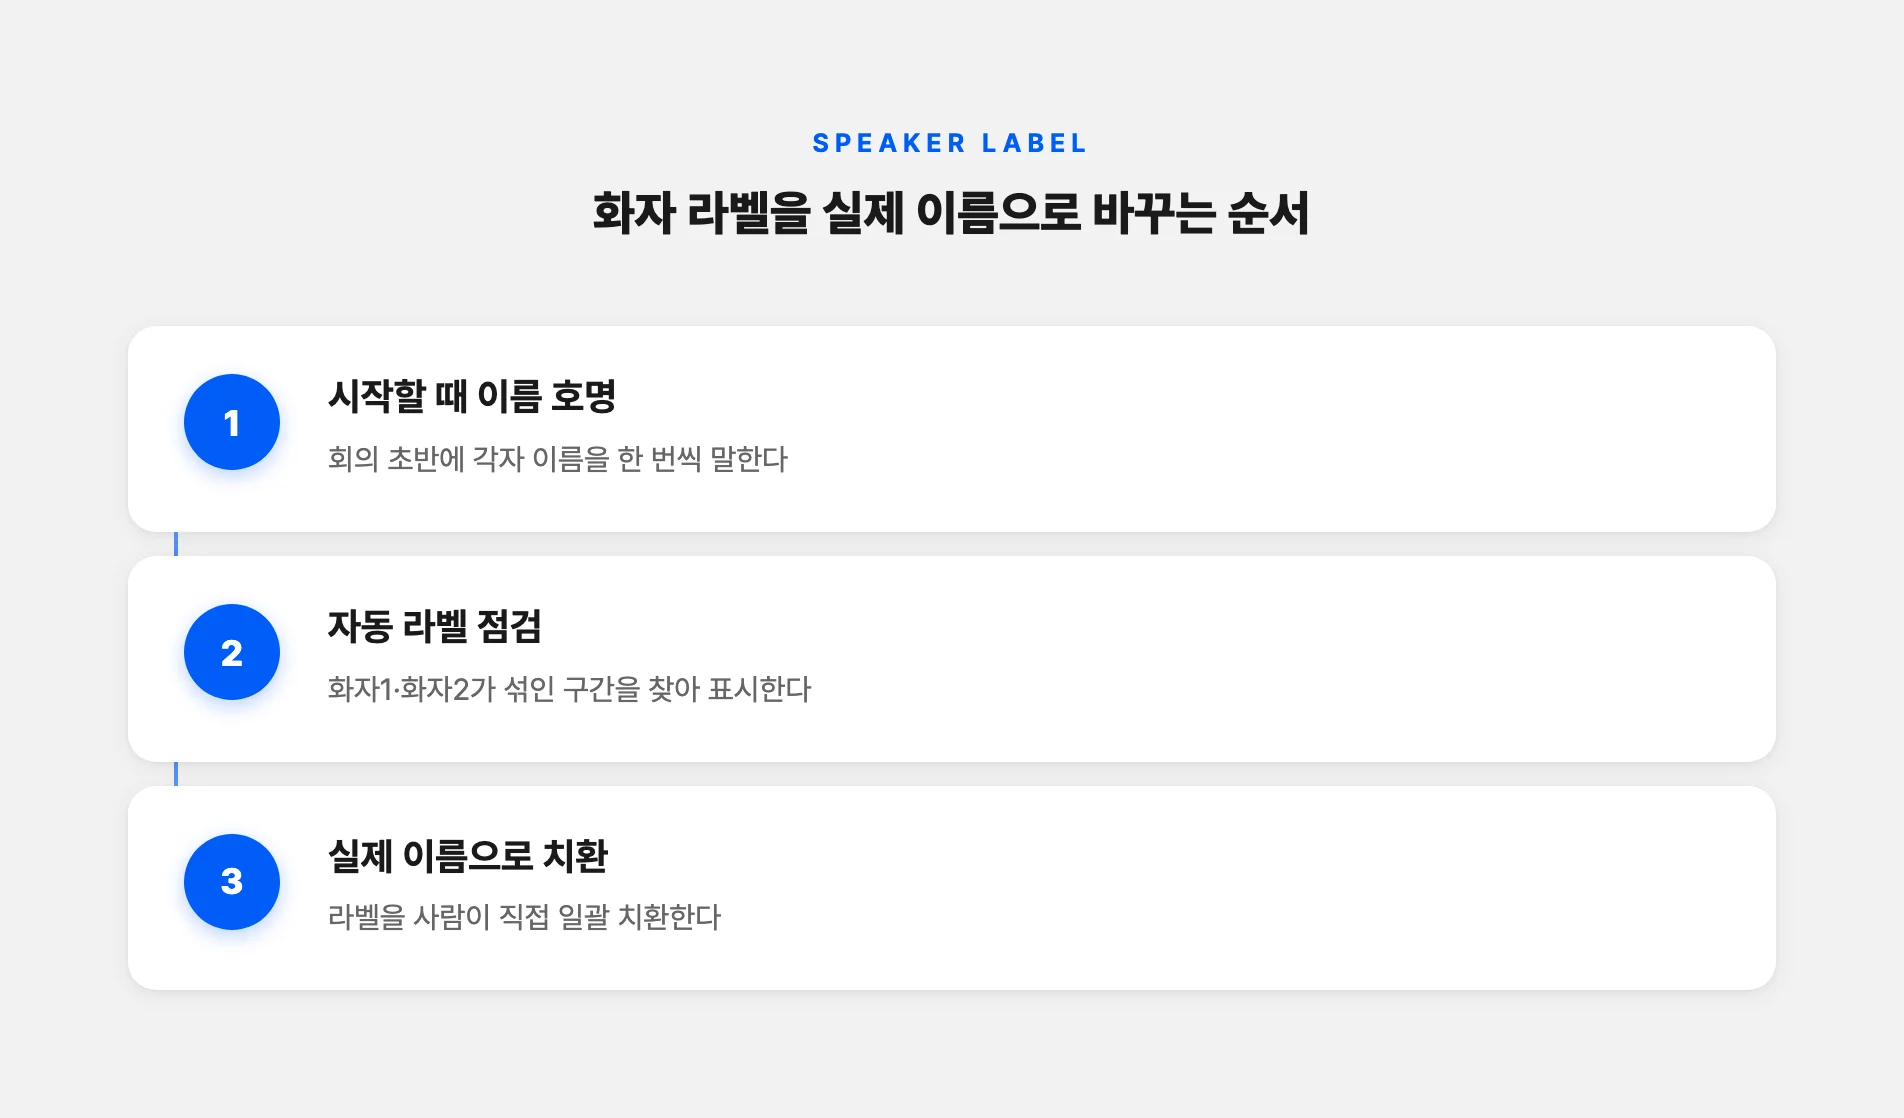
여기서 나는 두 가지를 하게 됐다. 회의 시작할 때 각자 이름 한 번씩 말하게 하는 것. 그리고 전사 끝난 뒤 ‘화자1·화자2’로 남은 라벨을 실제 이름으로 일괄 치환하는 검수를 꼭 넣는 것. 치환은 어차피 사람 손이 가야 하니까, 이건 AI한테 맡길 부분이 아니라고 마음을 접었다.
무료 한도랑 긴 파일, 여기서 제일 많이 막혔다
솔직히 정확도보다 여기서 더 자주 막혔다. 긴 강의나 연속 인터뷰를 한 도구에 몰아넣으면 월 중순에 한도가 바닥난다.
2026년 기준으로 자료를 대조해보니, 무료로 “무제한”은 사실상 없었다. 개인용 클로바노트는 무료로 쓰되 월 변환 시간과 AI 요약 횟수에 한도가 있다(대략 월 300~600분, 요약 월 15회 선). 다만 이 수치는 정리 글마다 조금씩 갈리고, 기업용 네이버웍스 클로바노트 요금표에는 개인 무료 항목이 아예 없이 유료 플랜만 나온다. 개인용 앱과 기업용이 분리돼 있어서 그런 것 같은데, 정확한 최신 한도는 결제 전에 앱에서 한 번 더 확인하는 게 안전하다.
| 도구 | 무료로 막히는 지점 |
|---|---|
| 클로바노트(개인) | 월 변환 시간·요약 횟수 한도 |
| 다글로 | 파일·유튜브 업로드 월 4시간 |
| Whisper(로컬) | 시간 제한 대신 세팅·한국어 정확도 부담 |
긴 파일은 무음이나 문단 단위로 잘라서 돌리는 게 낫더라. 특히 OpenAI Whisper는 입력을 30초 세그먼트로 잘라 처리하는데, 긴 오디오에서 무음 구간에 없는 말을 지어내기도 한다는 보고가 있다. 영어 데이터로 주로 학습돼 한국어가 영어만큼 정확하진 않다는 점도 감안해야 한다. 나는 결국 긴 회의는 애초에 구간을 나눠서 올리는 쪽으로 습관을 바꿨다.
“요약해줘”만 하면 꼭 뭔가 빠져 있더라
이 부분이 제일 무서웠다. AI 요약은 완전히 없는 걸 지어낸다기보다, 복잡한 내용을 과하게 압축하면서 중요한 전제나 예외 조건을 슬쩍 빼고 그럴듯한 한두 문장으로 만든다. 회의록에서 이게 제일 위험하다. 문장이 매끄럽고 전문 용어까지 들어가 있어서, 틀렸는지 티가 안 난다.
그래서 프롬프트를 바꿨다. “요약해줘” 대신 “결정사항 / 담당자와 기한(To-do) / 보류·미정 항목을 각각 뽑아줘”처럼 구조를 지정해서 시킨다. 개념 정리와 분석을 한 번에 안 시키고 단계로 쪼개는 거다. 그리고 요약본만 남기지 않는다. 전사 원문을 같이 보관해서 숫자와 결정사항을 대조한다. 요약이 곧 결론이 아니라는 걸, 한 번 잘못 옮겨 적고 나서야 몸으로 배웠다.
마지막으로 보안. 민감 정보가 든 녹음을 아무 데나 올리는 게 진짜 리스크다. 회사 승인 없이 임의로 쓰면 기밀이 외부 클라우드에 저장된다는 지적이 있고, 개인정보보호위원회도 생성형 AI 개인정보 처리 안내서를 냈다. 실명·연봉 같은 게 든 녹음은 올리기 전에 가리거나 로컬로 처리하고, 회사가 승인한 도구만 쓰는 걸로 나름의 선을 정해뒀다.
후배한테는 결국 이렇게 답했다. 뚝딱 나오긴 하는데, 그 뚝딱 나온 걸 믿고 쓰면 안 되더라고. 몇 달을 만졌는데도 나는 아직 검수 없이 요약본만 넘긴 적이 한 번도 없다. 도구가 게을러진 게 아니라, 내가 아직 그 정도로 못 믿는 거다.