한동안 국산 AI는 내 관심 밖이었다. 챗GPT 하나 켜놓으면 초안도 뽑고 표도 짜고 번역도 되는데, 굳이 국산을 찾아 쓸 이유가 없었다. 웹기획자로 일할 때 습관이 그랬다. 이미 잘 굴러가는 서비스가 있으면 새 걸 억지로 안 붙인다.
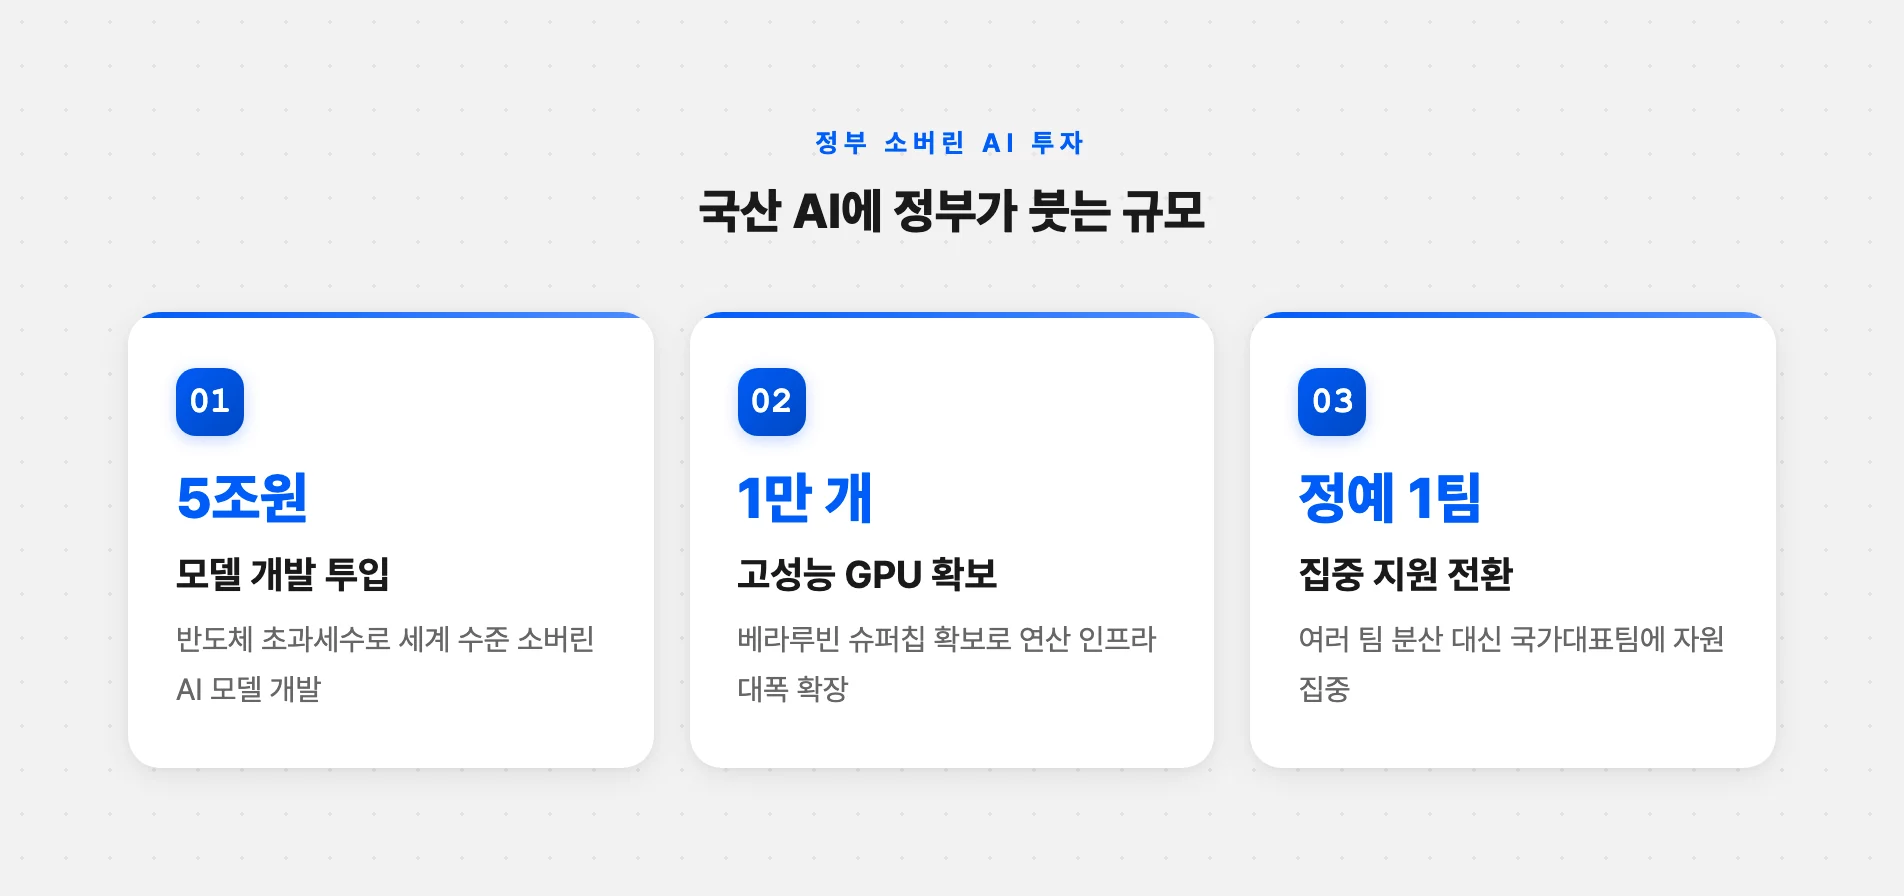
그러다 요 며칠 국산 AI, 소버린 AI라는 말이 여기저기서 튀어나왔다. 정부가 반도체 초과세수 중 5조원을 국산 모델 개발에 붓는다는 기사가 나왔고, 젠슨 황이 방한했다는 소식도 겹쳤다. 그런데 같은 창에서 네이버가 클로바X를 접었다는 걸 보고 좀 멈칫했다. 돈은 모델에 붓는데 정작 국민이 쓰던 서비스는 문을 닫았다는 게. 예전 같으면 그냥 넘겼을 소식인데, 이번엔 하나씩 눌러보게 됐다.
예전엔 안중에도 없던 국산 AI가 갑자기 국책 사업이 된 이유
소버린 AI, 말은 거창한데 풀어보면 단순하다. 자국 인프라·데이터·인력으로 외부 간섭 없이 AI를 굴리자는 개념이다. 데이터를 국내에 두는 데서 끝나는 게 아니라, 알고리즘부터 그걸 돌리는 GPU까지 다 자기 손 안에 두겠다는 거다. NVIDIA의 소버린 AI 설명을 보면 이 개념이 한 나라의 언어·문화·가치관을 반영한 독립 AI 체계를 말한다고 정리돼 있다.
기획자 시절 생각으로는, 이런 건 보통 위기의식에서 시작한다. 실제로 그랬다. 한국경제 보도에 따르면 미국의 AI 반도체 수출 통제로 “AI 종속국 전락” 위기감이 커진 게 직접적 배경이었다. 남의 나라 모델과 남의 나라 칩에 우리 데이터를 다 얹어놓고 살 순 없다는 거다.
그래서 정부(과기정통부)가 반도체 초과세수 중 약 5조원을 투입해 세계 수준의 소버린 AI 모델을 만들겠다는 계획을 내놨다. 엔비디아 베라루빈 슈퍼칩 약 1만 개를 확보하는 게 목표라는데, 예전엔 산하 팀들에 GPU를 700~800개씩 나눠주던 걸 이번엔 정예 한 팀에 1만 개를 몰아준다는 방향이라더라. 숫자를 읽다가 살짝 실감이 안 났다. GPU 1만 개면 그게 어느 정도인지 감이 잘 안 오는데, 하여튼 지금까지와는 규모가 다르다는 신호로는 충분히 읽혔다.
5개 팀에서 4개 팀으로, 정부가 고르고 있는 국가대표 모델
정부가 그냥 돈만 뿌리는 건 아니고, 정예팀을 추려내는 중이다. 이 과정이 은근히 서바이벌 같아서 눈이 갔다. 웹기획자로 여러 팀 프로젝트를 붙여본 사람 입장에선, 이렇게 단계평가로 걸러내는 방식이 결과가 좋을지 좀 궁금하기도 했다.
정책브리핑 자료 등을 정리해보면 흐름은 이렇다. 2025년 8월에 네이버클라우드·업스테이지·SK텔레콤·NC AI·LG AI연구원 5개 팀이 최종 선정됐고, 2026년 1월 1차 평가에서 LG·SKT·업스테이지 3팀이 통과했다. 2월엔 모티프테크놀로지가 정예팀으로 추가됐다. 지금(7~8월)은 이 네 팀이 8월 초 2차 평가를 앞두고 있고, 여기서 상위 3팀을 추리게 된다.
목표는 GPT나 Gemini 같은 글로벌 모델의 95% 이상 성능을 확보하는 한국형 독자 모델이라고 한다. 95%라는 숫자를 보고 잠깐 멈췄다. 나머지 5% 차이가 실제 써보면 어디서 갈리는지, 그게 진짜 궁금한 부분인데 숫자만으로는 알 수가 없다.
정작 국민이 쓰던 서비스는 문을 닫았다
여기서 아이러니가 하나 걸린다. 국가대표 모델을 고르느라 이렇게 공을 들이는데, 정작 국민이 실제로 쓰던 대화형 서비스는 줄어들고 있다는 거다.
네이버가 대표적이다. 대화형 클로바X와 검색형 큐를 2026년 4월에 종료했다. 2023년 8월에 나왔으니 약 2년 8개월 만이다. ZDNet 보도를 보면 챗GPT와의 성능 차이, 그리고 “한국어 특화”가 충분한 차별점이 되지 못한 게 이유로 꼽힌다.
처음엔 이걸 “국산 AI가 졌다”는 신호로 읽었다. 그런데 며칠 지나서 다시 보니 그게 아니었다. 네이버는 AI를 접은 게 아니라, 단일 챗봇을 접고 통합검색 안 ‘AI 탭’으로 재편하면서 하이퍼클로바X는 금융·제조·공공 같은 B2B 소버린 AI 공급으로 방향을 튼 거였다. 기획자 눈으로 보면 이건 서비스를 죽인 게 아니라, 앞단 제품 하나를 바꾸고 엔진은 다른 데 꽂은 셈이다. 소비자가 매일 켜는 챗봇 자리는 챗GPT에 내주고, 대신 기업·기관이 폐쇄망에서 안심하고 쓸 자리를 잡겠다는 거다.
그러니까 5조원이 향하는 곳도 실은 여기다. 모두가 쓰는 만능 챗봇을 국산으로 만들겠다기보다, 데이터 주권이 중요한 영역에서 남의 모델에 안 기대게 하겠다는 쪽이다. 이렇게 정리하고 나니 아까 걸렸던 아이러니가 조금 풀렸다.
그래서 지금 국산 모델은 어디까지 왔나
엔진 쪽만 보면 생각보다 멀리 와 있다. 나열하면 정보 덩어리가 되니, 지금 이름이 오르내리는 것만 추려봤다.
| 모델 | 만든 곳 | 지금 위치 |
|---|---|---|
| 하이퍼클로바X | 네이버 | THINK 추론모델·SEED 오픈소스 공개, B2B 전환 중 |
| 엑사원 | LG | 4.5 멀티모달 공개, 포털 줌에 적용 |
| Solar | 업스테이지 | Pro 3(102B) 공개, 한국어 벤치마크 선도 |
| A.X | SKT | A.X K2 구축, 에이전틱 AI 강화 |
| 카나나 | 카카오 | 오픈소스 4종 공개, 카카오톡 적용 중 |
숫자만 옮기면 재미가 없으니 눈에 걸린 것만 짚자면, LG 엑사원은 2026년 1월 글로벌 평가기관 지수에서 세계 7위·국내 1위를 기록했다고 한다. 업스테이지 Solar Pro 2는 한국어 벤치마크에서 GPT-4.1을 앞섰다는 평가도 나왔다. 이런 성적표를 읽을 땐 늘 반쯤 접어두고 본다. 벤치마크 1등이 내 작업에서 1등이라는 뜻은 아니라는 걸, 도구 몇 번 갈아타보며 배웠다.
그중 제일 반가웠던 건 네이버·LG·업스테이지·카카오 모델이 다 오픈소스나 오픈웨이트로 풀려 있다는 점이다. 하이퍼클로바X SEED는 국내 첫 상업용 무료 오픈소스 LLM이라더라. 개발자나 기업이 자기 서비스에 이 엔진을 그대로 이식할 수 있다는 뜻이다. 다만 여기서 기획자 본능이 발동한다. 엔진이 풀렸다는 것과, 나 같은 일반 사용자가 바로 켜서 쓸 제품이 있다는 건 완전히 다른 얘기다.
챗GPT 대신 지금 눌러볼 만한 건 따로 있다
그래서 직접 눌러봤다. 거창한 실험은 아니고, 로그인 없이 되는 것부터.
포털 줌(ZUM)의 ‘AI 1초 요약’은 K-엑사원이 들어간 기능인데, 로그인 없이 바로 눌러진다. 뉴스 요약 정도는 무난했다. 재밌는 건, 이걸 쓰는 사람 대부분이 자기가 국산 모델을 쓰고 있다는 걸 모른다는 거다. 엔진이 뒤에 숨어 있으니까. SKT 에이닷은 앱으로 깔아야 하지만 국내 챗봇 MAU 3위, 약 180만 명이 쓰고 있다. 뤼튼은 카톡형 UI로 편해서 국내 4위다.
여기까지 눌러보고 나서 든 생각은 이거다. 만능 대화형 챗봇 자리는 아직 챗GPT다. 국내 AI 챗봇 MAU 1위가 챗GPT 2,162만 명인데, 2위·3위와 열 배 넘게 벌어져 있다. 글쓰기·요약·번역·이미지·음성·파일 분석을 한 창에서 처리하는 통합력에서 국산은 아직 폭이 좁다.
대신 갈리는 지점이 분명히 있다. 한국어 문서를 많이 다루거나, 데이터를 밖으로 못 내보내는 회사·공공기관 업무라면 국산 쪽이 유리해지는 중이다. 온프레미스로 자기 서버 안에서 돌릴 수 있다는 건 챗GPT가 쉽게 못 주는 강점이니까. 정부는 연내에 무료로 쓰는 ‘모두의 AI’도 내놓겠다고 밝혔는데, 다만 대통령실 하정우 수석조차 “일반 국민은 모델을 그대로 쓰기 어려워 쉽게 쓸 툴이 추가로 필요하다”고 짚었다. 이 문장이 딱 오늘 내가 느낀 거였다. 엔진은 왔는데 제품이 덜 왔다.
가격·무료 한도·모델 버전은 워낙 자주 바뀌니, 실제로 업무에 붙이기 전엔 각 공식 페이지를 한 번 더 확인하는 게 맞다. 이 글도 2026년 7월 기준 공개 자료와 보도를 대조한 거라, 몇 달 뒤엔 또 판이 달라져 있을 거다.
국산 AI야. 엔진은 잘 만들었으니, 이제 우리가 매일 켜고 싶은 얼굴 하나만 제대로 붙여주라.