내 블로그 글은 검색엔진만 긁어가는 줄 알았다.
구글봇이 와서 색인하고, 그래서 검색에 뜨는 거고. 딱 거기까지였다. 그런데 얼마 전 로그 비슷한 걸 들여다보다가 처음 보는 이름들이 눈에 걸렸다. GPTBot. ClaudeBot. 뭐지 이거. 챗GPT랑 관련된 것 같긴 한데 왜 내 블로그에 오나 싶었다.
찾아보니 AI 회사들은 검색용 봇 말고 학습 데이터를 긁어가는 전용 크롤러를 따로 돌린다더라. 내가 심심할 때 끄적인 글도, 반나절 붙잡고 쓴 글도, 그 봇들 입장에선 다 재료였던 거다. AI 저작권이라는 말이 남 얘기인 줄 알았는데, 알고 보니 내 블로그 글 한 편 한 편이 그 한복판에 있었다.
검색봇인 줄 알았던 그 이름들, 사실은 학습용이었다
가장 먼저 헷갈린 게 이거였다. 구글봇이랑 뭐가 다른 건데.
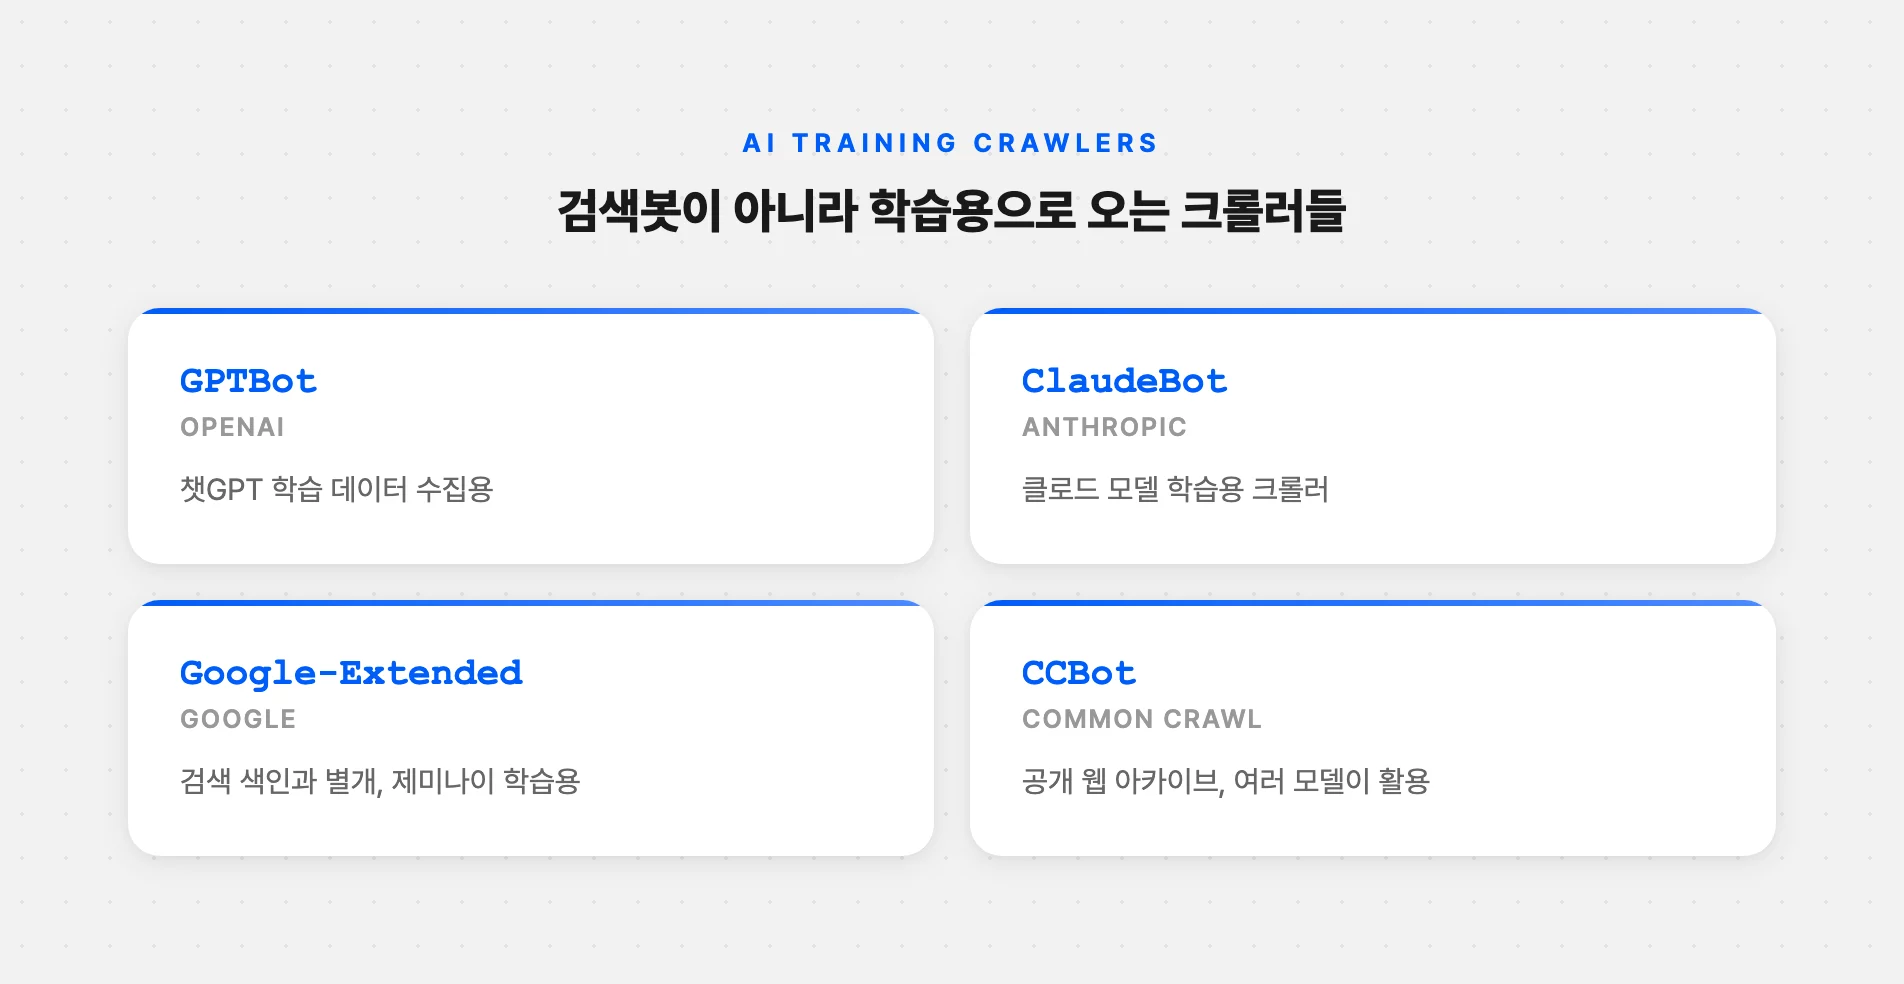
robots.txt AI 크롤러 가이드를 대조해보니, 이름부터 갈렸다. GPTBot은 오픈AI가 챗GPT 학습 데이터를 모으려고 돌리는 봇이고, ClaudeBot은 앤트로픽(클로드) 쪽 크롤러다. 구글도 검색 색인용 Googlebot과 별개로 Google-Extended라는 걸 따로 두는데, 이건 제미나이 학습용이다. Common Crawl이 돌리는 CCBot도 있는데, 공개 웹을 통째로 아카이브해서 여러 AI 모델이 여기서 데이터를 가져간다.
읽고 나서야 알았는데, 그러니까 “검색에 뜨는 것”과 “AI 학습에 들어가는 것”이 완전히 다른 문이었던 거다. 나는 그동안 문을 하나로 알고 있었고.
규모를 보면 더 실감이 난다. GPTBot 트래픽은 1년 만에 305% 늘어서, 2025년 5월 기준 전체 봇 트래픽의 7.7%를 차지했다. 그런데도 웹사이트의 약 86%는 AI 봇에 대해 아무 설정도 안 해둔 상태라더라. 나도 그 86% 안에 있었던 거고. 신문·잡지 같은 인쇄 매체 출신은 57%가 이미 AI 크롤러를 막았다는데, 이쪽은 확실히 경계심이 빠르다.
robots.txt 열어서 GPTBot을 막아봤다
말로만 “막을 수 있다”는 게 답답해서 실제로 열어봤다.
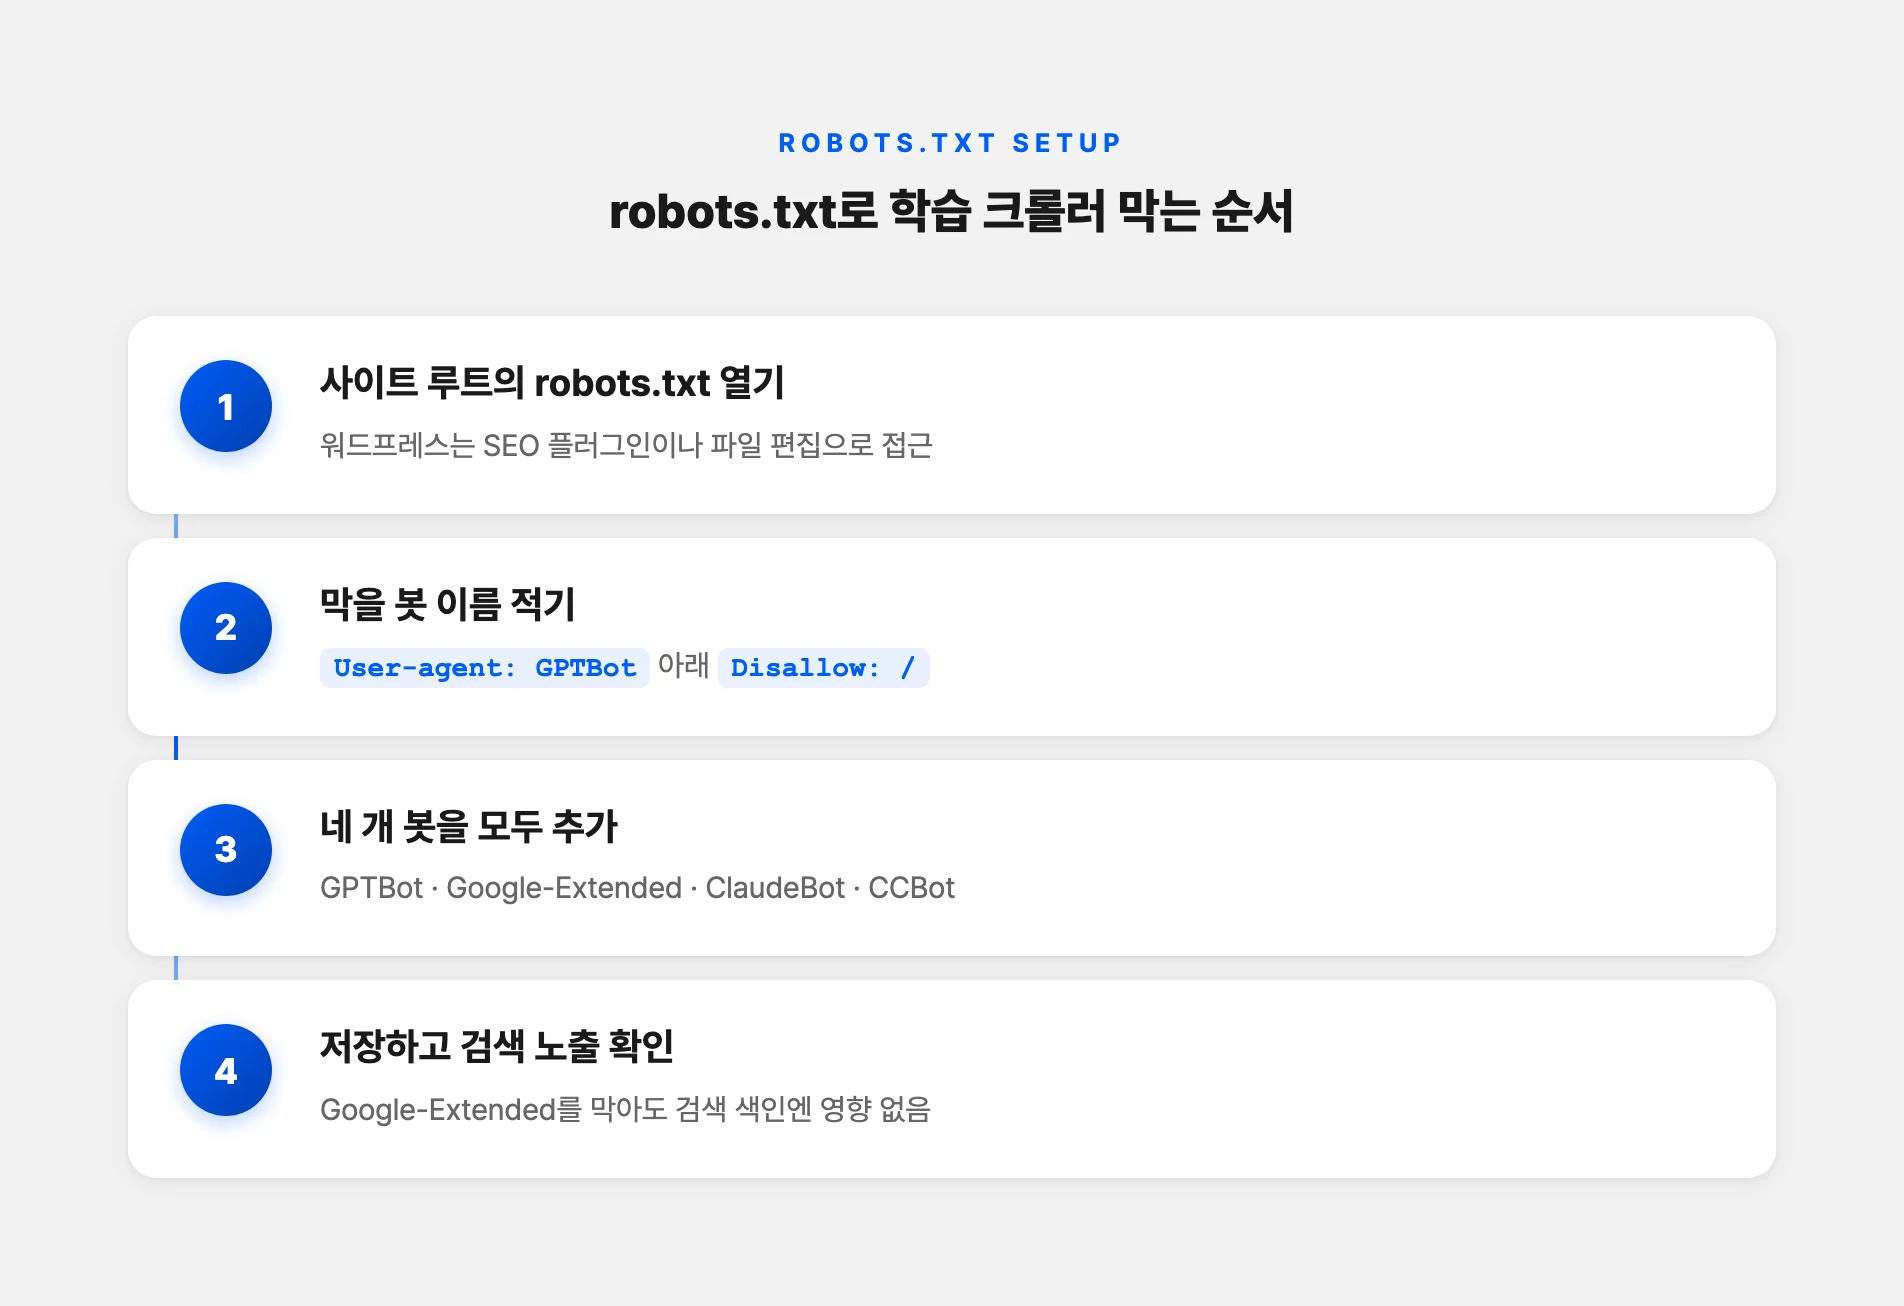
사이트 루트의 robots.txt 파일에 어떤 봇을 막을지 적는 방식이다. 나는 이런 걸 예전 웹기획 하던 시절에 SEO 담당이 만지는 거 옆에서만 봤지, 직접 이 용도로 손대본 건 처음이었다. 형식은 생각보다 단순했다. 막고 싶은 봇 이름을 User-agent에 쓰고, 아래에 Disallow: /를 붙이면 사이트 전체를 못 긁게 하는 식이다.
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /
GPT봇 차단 방법을 정리한 ITWorld 글을 보면 워드프레스는 SEO 플러그인이나 파일 편집으로 이 규칙을 넣을 수 있다고 나온다. 나처럼 워드프레스로 블로그를 굴리는 사람이면 크게 어렵지 않다.
여기서 하나 알아두면 좋은 게, Google-Extended를 막아도 구글 검색 노출에는 영향이 없다는 점이다. 검색 색인용 Googlebot은 그대로 오고, 제미나이 학습용만 빠지는 거다. 검색 유입은 지키면서 학습만 뺄 수 있다는 소리라, 나는 이게 제일 반가웠다. 검색까지 끊길까 봐 사실 이거 하나 때문에 망설이고 있었거든.
막았다고 안심했는데, 이미 늦은 부분이 있었다
여기까지 하고 좀 뿌듯했다. 이제 내 글은 안전하다, 생각했다.
아니었다. 며칠 지나서 다시 읽어보니 robots.txt는 그렇게 만능이 아니었다. 이건 법적 강제력이 있는 규정이 아니라 봇이 “자율적으로 지키기로 한 약속”에 가깝다. GPTBot이나 ClaudeBot 같은 주요 봇은 존중한다고 밝혔지만, 규칙을 무시하는 악성 스크래퍼한테는 애초에 소용이 없다. 더 뼈아픈 건, robots.txt는 “앞으로의 방문”만 막을 뿐이라는 거다. 이미 긁혀서 학습에 들어간 데이터는 되돌리지 못한다. 내가 몇 년치 글을 이제 와서 막아봤자, 그전에 지나간 건 이미 어딘가 모델 안에 녹아 있을 수 있다는 얘기다.
그러면 내가 챗GPT나 클로드에 직접 입력하는 것들은 어떤가. 이것도 학습 데이터가 될 수 있다길래 설정을 뒤졌다. 대체로 각 서비스의 데이터 관리(설정 → 데이터 컨트롤 비슷한 메뉴)에서 모델 학습에 쓰는 항목을 끄면 된다. 임시 채팅을 쓰면 저장·학습이 안 되는 방식도 있다. 다만 이 메뉴 이름들은 서비스 UI가 자주 바뀌니, 지금 이 글의 메뉴명을 그대로 믿기보다 각자 설정에서 “모델 개선/학습” 비슷한 항목을 직접 찾는 게 정확하다. 이건 나도 화면 캡처 없이 말로만 옮기는 거라 조심스럽다.
이미지 작업을 하는 사람이라면 Spawning의 “Have I Been Trained?” 같은 도구로 내 그림이 이미지 모델 학습 데이터셋에 들어갔는지 검색하고 학습 제외를 등록할 수도 있다. 다만 오픈AI가 예고했던 크리에이터용 opt-out 도구 ‘미디어 매니저’는 2026년 지금까지도 실제로 나오지 않았다. 그러니까 “여기 등록하면 앞으로 확실히 빠진다”고 보장하는 통합 창구는 이미지 쪽엔 아직 없다는 거다.
그럼 내가 AI로 뽑은 글은 누구 것인가
막는 얘기만 하다 보니 반대쪽이 궁금해졌다. 내가 AI한테 시켜서 만든 글이나 이미지는, 그럼 내 저작물인가.
여기서 한국과 미국이 신기하게도 같은 방향을 보고 있다. 한국은 문화체육관광부와 한국저작권위원회가 2025년 6월 생성형 AI 활용 저작물의 저작권 등록 안내서를 냈는데, 사람이 창작 과정에 실질적·창작적으로 기여했으면 등록이 가능하고, 프롬프트만 넣어 AI가 알아서 뽑은 산출물은 그 자체로는 저작권 보호를 못 받는다고 선을 그었다.
미국 저작권청도 2025년 1월 보고서에서 거의 같은 결론을 냈다. 인간의 저작자성이 저작권의 근간이고, 프롬프트는 아무리 상세해도 그것만으로는 저작권을 주지 않는다는 거다. 프롬프트를 “표현”이 아니라 “지시”에 가깝다고 본 대목이 인상적이었다. 다만 두 나라 모두, 사람이 AI 결과물을 창의적으로 선택·배열·수정하거나 자기 창작물에 보조 도구로 쓴 경우는 보호가 가능하다고 열어뒀다.
이걸 내 블로그에 대입하면 좀 서늘해진다. 정리하면 이렇다.
| 만든 방식 | 저작권 |
|---|---|
| 프롬프트만 넣어 AI가 뽑은 글·그림 | 보호 어려움, 남이 써도 막기 힘듦 |
| 사람이 실질적으로 편집·재구성·창작 추가 | 보호 가능, 그 기여 부분이 내 것 |
AI로 대충 뽑아 올린 글은 남이 그대로 퍼가도 저작권으로 막기가 어렵다는 소리다. 반대로 내가 자료 찾고 겪은 걸 넣고 문장을 다시 짠 글은 그 손댄 부분이 내 몫으로 남는다. 요즘 실제 소송도 이 결을 따라간다. 앤트로픽은 작가들에게 15억 달러에 합의했는데, 학습 자체보다 불법 복제본을 가져다 쓴 게 문제가 됐다. 학습이냐 아니냐보다 “어디서 가져왔느냐”가 갈림길이 된 거다.
결국 오늘 내가 할 일은 정해졌다. robots.txt에 봇 이름 네 개부터 적어 넣어야겠다. 이미 지나간 건 어쩔 수 없어도, 오늘 쓴 글부터는 내가 문을 열지 말지 정할 수 있으니까.