며칠 전 내 인스타 계정을 위에서 아래로 쭉 내려봤다. 별생각 없이 올린 것들이었다. 카페에서 찍은 셀카, 아이 학교 행사 영상, 친구랑 통화하다 웃으면서 찍어 올린 짧은 클립. 그중 목소리가 또렷하게 담긴 영상이 몇 개 눈에 걸렸다. AI 딥페이크가 3초짜리 음성만 있어도 사람 목소리를 통째로 복제한다는 걸 읽고 나서였다.
예전엔 딥페이크라고 하면 그냥 남 얘기였다. 표정이 어딘가 어색하고, 입 모양이 안 맞고, 유명인 얼굴을 어설프게 갖다 붙인 합성 영상. 웃긴 짤 정도로 봤다. 그런데 지금은 그 단계를 한참 지났더라. 웹기획자로 일할 때 본인확인이니 신뢰 흐름이니 하는 걸 화면에 그리곤 했는데, 그 전제가 통째로 흔들리는 얘기라 남 일처럼 안 넘어가졌다.
합성 티가 나던 시절은 지났더라
가장 먼저 놀란 건 딥보이스였다. 3초. 공개된 영상이나 통화 녹음, 유튜브 인터뷰 몇 초만 있어도 억양과 말투까지 학습해 복제한다는 거다. 이건 한 군데서만 나온 얘기가 아니라 국내 KISA 계열 자료부터 해외 보안업체 자료까지 “as little as three seconds”로 똑같이 짚고 있었다. 처음엔 과장 아닌가 싶었는데, 여러 곳이 같은 숫자를 말하니까 다시 봤다.
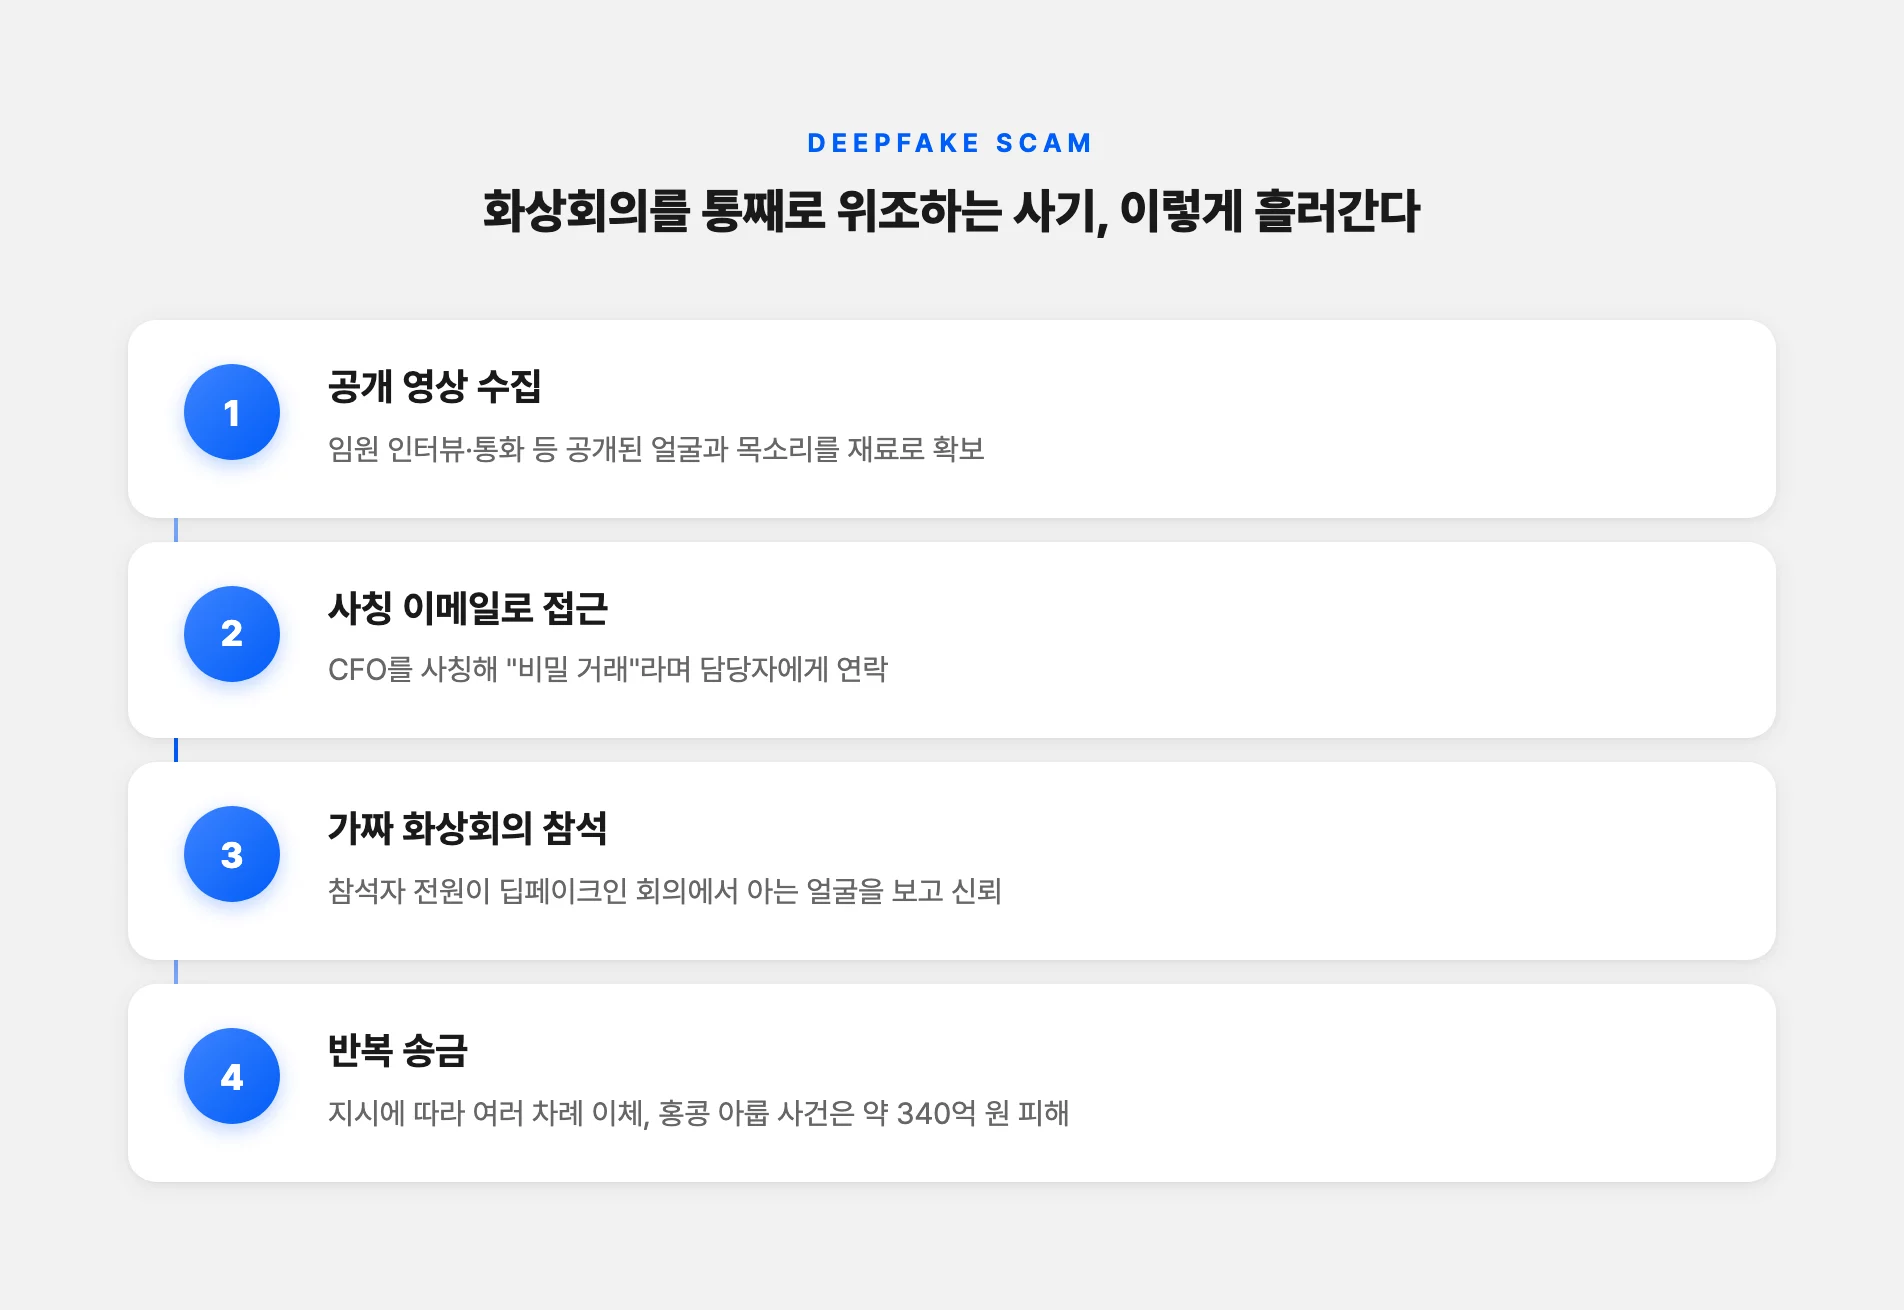
영상은 더 나갔다. 이제는 녹화된 영상이 아니라 실시간 화상회의에서 얼굴과 목소리를 통째로 위조하는 수준까지 왔다. 대표적인 게 2024년 홍콩에서 있었던 아룹(Arup) 사기 사건이다. 한 재무 직원이 참석자 전원이 딥페이크로 만들어진 가짜 화상회의에 속아, 열다섯 번에 걸쳐 우리 돈으로 약 340억 원을 송금했다. 시작은 CFO를 사칭한 이메일이었고, 직원도 처음엔 의심했다. 그런데 화면에 CFO와 동료들 얼굴이 다 나오는 회의를 보고 믿어버린 거다. 그 얼굴과 목소리가 전부 공개된 회사 임원 영상으로 만든 가짜였다는 게 CNN 보도로 드러났다.
이 대목에서 좀 서늘했다. 나라도 그 상황이면 안 믿었을까. 화면에 아는 얼굴이 여럿 나와서 말을 거는데. 아룹 측도 “이런 일이 사람들이 생각하는 것보다 훨씬 자주 일어난다”고 했단다. 그러니까 이건 특별히 어리숙한 사람이 당한 사고가 아니라는 거다.
유명인만 당하는 일이 아니라는 게 핵심
여기까지 읽고 나면 “그래도 나는 340억을 송금할 일이 없는데” 싶다. 나도 그랬다. 그런데 개인한테 오는 위험은 결이 좀 다르더라.
현실적인 시나리오는 두 가지였다. 하나는 가족 사칭 보이스피싱. 내 목소리, 혹은 자녀나 부모 목소리를 복제해서 다른 가족에게 “급하게 돈 보내라”고 하는 거다. 국내에서도 AI로 가족 목소리를 복제해 “납치했다”, “사고 났으니 돈을 보내라”고 하는 사기가 중장년층을 겨냥해 경고되고 있다. 다른 하나는 내 얼굴 도용. SNS에 올린 사진이 성적 합성물이나 가짜 투자 광고, 가짜 프로필에 쓰이는 경우다.
내가 인스타를 다시 훑어본 게 이 대목 때문이었다. 얼굴 사진이야 그렇다 쳐도, 목소리가 또렷하게 담긴 영상이 이렇게 많았나 싶었다. 딱히 유명하지도 않은 내 계정이 재료 창고였던 셈이다.
그래서 실제로 뭘 했느냐면, 거창한 건 아니다. 전체 공개로 열어둔 영상 몇 개를 친구 공개로 돌리거나 내렸다. 그리고 가족 단톡방에 하나 정해두자고 했다. 급하게 돈 요구하는 전화가 오면 물어볼 우리끼리의 확인용 단어. KISA도 AI 음성 사기는 단순 차단이 어려워서 가족 간 사전 예방이 무엇보다 중요하다고 짚었는데, 읽고 나서야 이게 왜 기술보다 앞서는 얘기인지 알겠더라. 여기에 하나 더, 돈이나 계좌 얘기가 나오면 그 통화 안에서 처리하지 말고 평소 알던 번호로 다시 걸어 확인하기. 사기의 공통 각본이 “비밀”, “지금 당장”, “아무한테도 말하지 마라”인데, 아룹 사건의 미끼도 딱 “비밀 거래”였다.
진짜인지 가짜인지, 눈으로 잡히는 단서
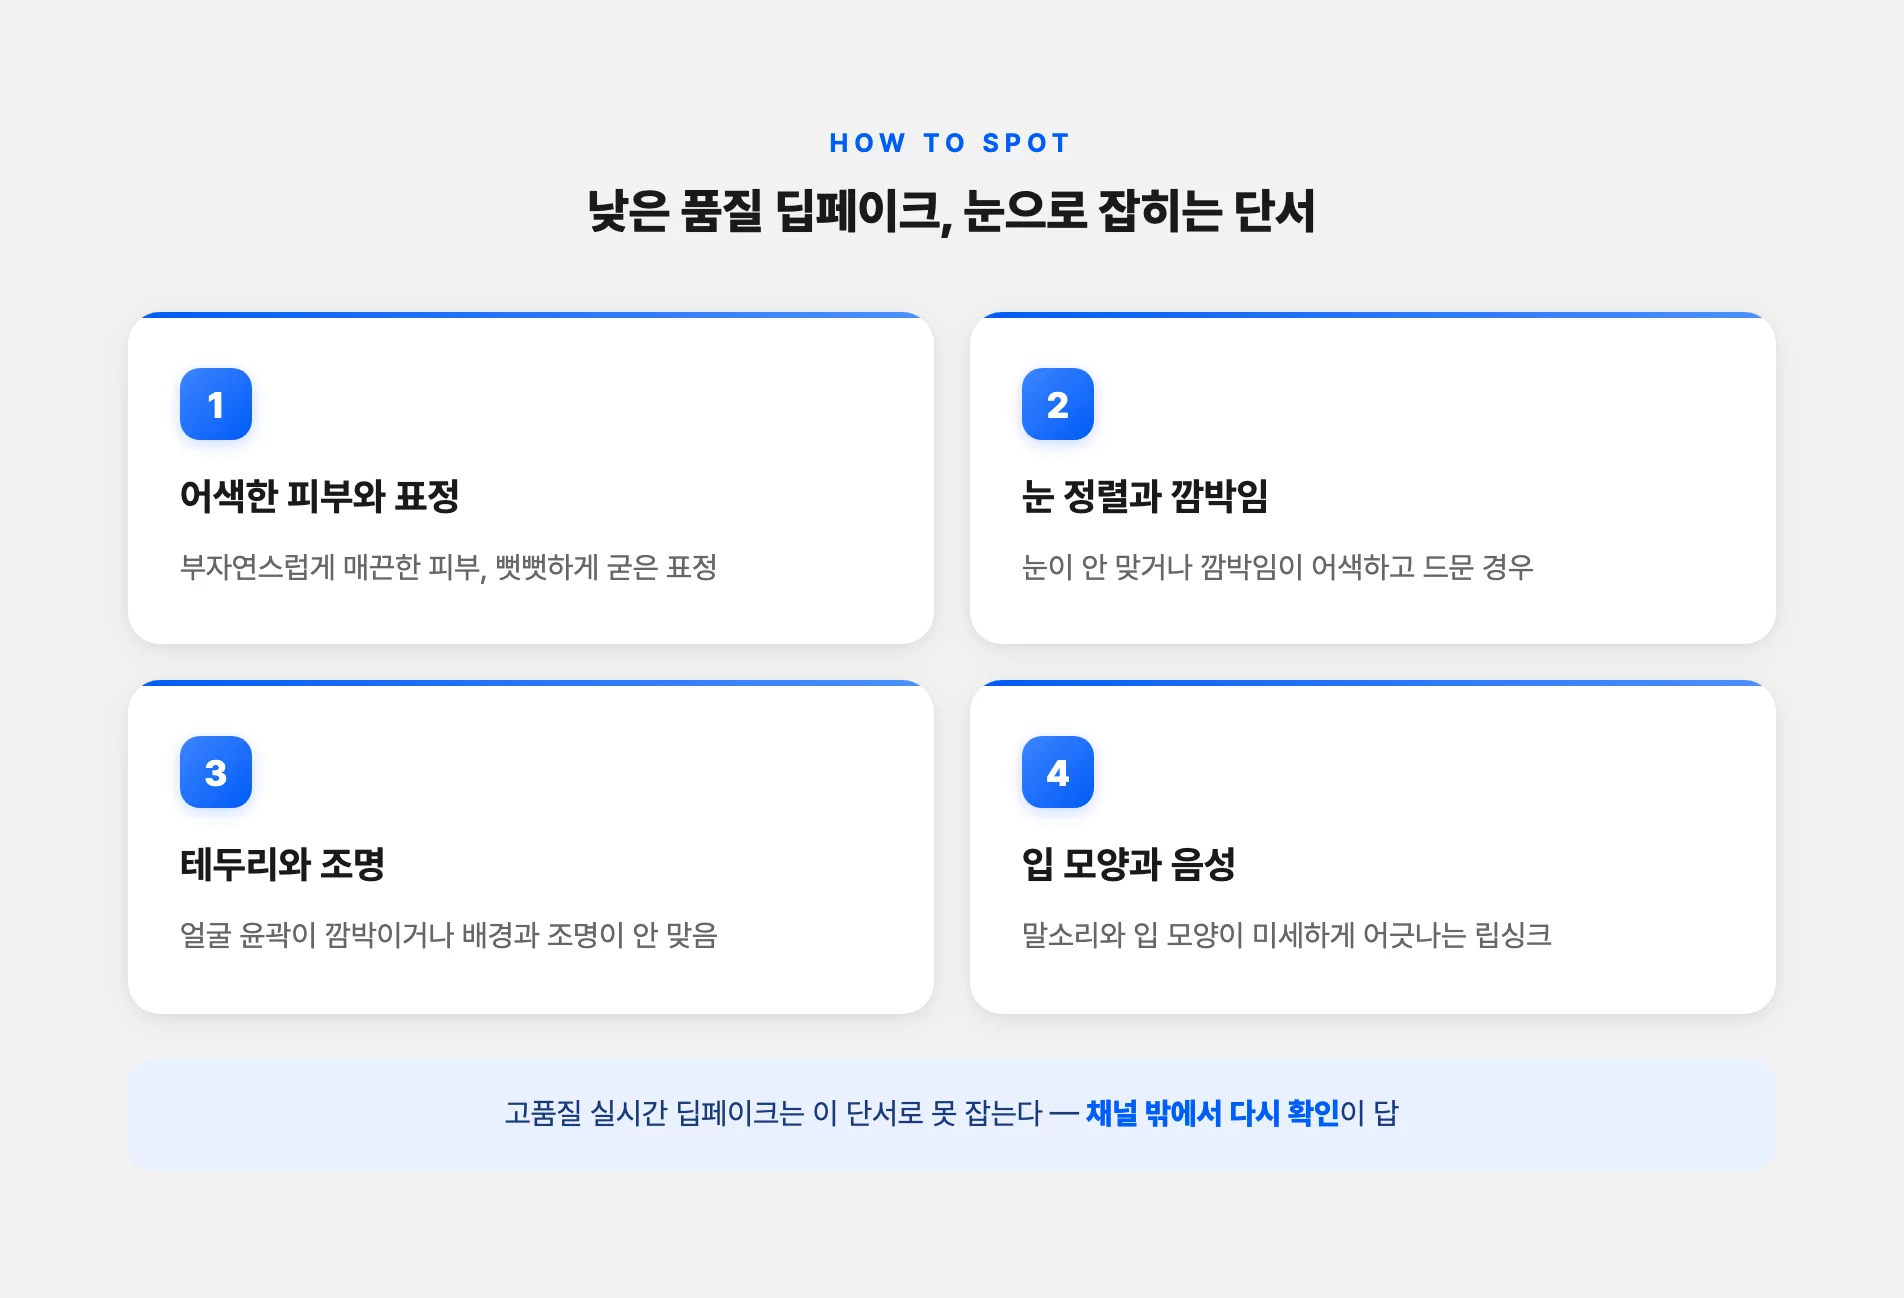
그럼 보면 티가 나느냐. 낮은 품질 딥페이크는 아직 단서가 있다. 부자연스럽게 매끈한 피부, 뻣뻣한 표정, 눈 정렬이 안 맞거나 눈 깜박임이 어색한 것. 얼굴 윤곽에서 테두리가 깜박거리거나, 배경과 인물의 조명이 안 맞는 것. 그리고 음성과 입 모양이 미세하게 어긋나는 립싱크 문제. 이 정도는 집중해서 보면 걸린다.
문제는, 아룹 사례처럼 잘 만든 실시간 딥페이크는 이런 걸로 못 잡는다는 거다. ESET 같은 보안업체 안내를 봐도, 시각 단서는 어디까지나 1차 필터일 뿐 최신 고품질에는 통하지 않는다고 못을 박는다. 그래서 결국 “이 화면이 진짜냐 가짜냐”를 판별하려 애쓰기보다, “이 채널 밖에서 다시 확인한다”는 행동 규칙이 더 강하다는 얘기로 돌아온다.
탐지 도구도 찾아봤다. DeepFake-o-Meter처럼 의심 미디어를 올리면 AI 생성 가능성을 퍼센트로 알려주는 무료 도구도 있고, Reality Defender 같은 상용 플랫폼도 있다. 다만 이걸 직접 돌려본 건 아니라 조심스럽게 쓴다. 공통점은 하나다. “AI 생성일 확률 몇 퍼센트”를 알려줄 뿐 확정은 아니라는 것. 결국 도구는 참고고, 판단은 사람 몫으로 남는 구조였다.
AI 기본법은 이걸 뭐라고 표시하래
기술이 이러면 규제는 어디까지 왔나 궁금해서 찾아봤다. 마침 한국은 올해 관련 법이 막 시행됐다. 「인공지능 발전과 신뢰 기반 조성 등에 관한 기본법」, 줄여서 AI 기본법이 2026년 1월 22일부터 시행됐다.
핵심은 표시 의무다. 생성형 AI로 만든 결과물엔 “AI가 생성했다”는 사실을 표시해야 한다. 그런데 딥페이크는 조건이 더 세다. 일반 생성물은 사람이 인식 가능한 표시 또는 워터마크·메타데이터 같은 기계 판독 방식 중 골라도 되는데, 딥페이크 결과물은 이용자가 명확히 알아볼 수 있는 ‘가시적 표시’만 허용한다. 정책브리핑 설명을 보면 딥페이크 조항은 계도기간 없이 시행과 동시에 바로 적용된다고 한다. 다른 표시 의무엔 유예가 있어도 딥페이크는 즉시라는 거다.
여기서 웹기획자 시절 감각이 다시 튀어나왔다. 표시 의무가 생기면 결국 화면 어딘가에 그 라벨을 어떻게 얹느냐가 실무 문제가 된다. 그리고 이건 한국만의 일도 아니었다. EU도 AI Act 제50조 투명성 의무가 2026년 8월 2일부터 구속력을 갖게 됐고, 업계는 C2PA 콘텐츠 자격증명과 구글 SynthID 워터마크를 묶는 방향으로 가고 있다. 구글은 이 검증을 검색과 크롬에 기본으로 넣겠다고 밝혔다더라. 파일 자체에 “언제 어떤 AI로 만들었는지”가 붙어 다니는 세상으로 가는 중인 셈이다.
만에 하나 피해를 봤을 때 어디에 신고하는지도 적어둔다. 불법 합성물은 경찰청 사이버범죄 신고에 증거를 확보해 신고하고, 불법 성적 합성물이라면 삭제지원 플랫폼(d4u.stop.or.kr)에 삭제를 요청할 수 있다. 이건 시간 지나도 안 바뀌는 정보라 저장해두면 쓸 데가 있다.
이렇게 정리해놓고 보니, 결국 방어의 무게 중심은 기술이 아니라 습관에 있다고 쓰려던 참이었다. 아니, 그건 절반만 맞는 말이다. 습관만으론 안 되고, 표시 의무 같은 제도가 뒷받침돼야 개인이 애초에 판별에 매달리지 않아도 되는 쪽으로 간다. 개인이 다 감당하라는 얘기로 끝나면 곤란하니까.
가족 단톡방에 확인용 단어 하나 정하는 거, 그것부터 오늘 해두자. 목소리 복제는 3초면 되는데 이건 3초도 안 걸린다.