검색창에 “GPT-5.6″이라고 치다가 손이 멈췄다. 어제는 5.5였나, 아니 Pro였나. 갈아타야 하나 싶어 검색하려던 건데, 정작 지금 내가 쓰는 게 몇 버전인지부터 헷갈렸다. AI 신모델 소식은 매일 알림으로 오는데, 그중에 내가 진짜 갈아탈 이유가 되는 건 몇 개나 될까. 그걸 좀 정리해두고 싶었다.
새 모델이 나올 때마다 갈아타는 게 습관이 됐던 시절이 있었다. 그러다 몇 번 데인 뒤로는, 발표를 보는 눈이 좀 달라졌다.
사흘에 한 번씩 새 모델이 나온다는데
llm-stats.com의 2026년 8월 업데이트 집계를 보면, 요즘은 주목할 만한 모델이 몇 달에 한 번이 아니라 강력한 오픈소스까지 포함하면 대략 사흘에 한 번꼴로 나온다. 2026년 3월 한 달에만 OpenAI·Anthropic·Google·NVIDIA를 합쳐 30개 넘는 새 모델이 나왔다는 정리도 있었다(blog.mean.ceo). 그러니 알림이 매일 뜨는 게 당연했다.
문제는 이름이다. 각 회사가 몇 달마다 조금씩 손보면서 “.5” 붙는 릴리스나 새 티어 이름이 계속 생긴다. 최근에 화제였던 것만 훑어도 GPT-5.5에 Pro·Instant 변형, GPT-5.6, Claude Opus 4.6에서 4.8, Gemini 3.1 Pro, Qwen 3.5까지. 매일 쓰는 사람도 버전 번호가 헷갈린다는 게 버전 피로(version fatigue) 이야기로 돌아다닌다. 기획할 때 이런 걸 “사용자에게 변화를 제대로 설명 못 하는 릴리스 노트” 문제라고 불렀는데, 딱 그 꼴이다.
여기서 내가 자꾸 흔들렸던 게, 출시량을 업무 가치랑 헷갈린 거였다. 릴리스가 잦다는 것과 매번 갈아타야 한다는 건 전혀 다른 말인데.
벤치마크 점수가 올랐다는 발표
새 모델은 대부분 벤치마크 점수가 올랐다는 걸로 홍보된다. 처음엔 그 숫자를 꽤 믿었다. 점수가 높으면 내 작업에서도 나아지겠거니 했다.
며칠 지나서 다시 보니 그게 아니었다. 숫자와 실사용 사이에는 생각보다 큰 틈이 있었다. Kili Technology의 2026년 벤치마크 정리에 따르면, 통제된 실험실 자동 평가는 실제 현장 유용성을 과대평가하는 경향이 있고, 기업용 에이전트 AI의 경우 랩 점수와 실제 배포 성능 사이에 37% 격차가 보고된다. 그 정도면 발표 숫자만 보고 갈아탄 게 좀 민망해진다.
이유도 하나가 아니었다. 모델이 학습 중에 벤치마크 문항을 이미 봤으면 점수는 실력이 아니라 정답 암기를 반영할 수 있다는 데이터 오염 문제(chatbench.org). 종합 점수는 여러 작업을 평균 낸 값이라 내 실제 사용 사례랑 분포가 다를 수 있다는 것. 경쟁 프로그래밍을 압도하는 모델이 실무 코드 리뷰에서는 못할 수 있다는 예시(medium.com의 AI Model Hype 글)를 읽고 나서야, 종합 1등이 내 1등은 아니라는 게 확실해졌다. 게다가 제작사 자체 벤치마크는 제3자 평가보다 더 의심하고 봐야 한다더라.
정리하면 이렇다. 벤치마크는 “이 모델이 존재할 가치가 있나”는 걸러준다. 그런데 “내가 갈아타야 하나”에는 답을 못 한다. 그건 내 작업으로만 정해진다.
갈아타는 데 드는 눈에 안 보이는 비용
한번은 새 모델이 좋다길래 블로그 자동화 파이프라인 프롬프트를 통째로 새 모델에 맞춰 바꾼 적이 있다. 결과가 확 좋아질 줄 알았는데, 잘 돌아가던 몇 개가 조용히 어긋났다. 오류가 뜨는 것도 아니고 그냥 미묘하게 결과가 달라져서, 뭐가 문제인지 찾는 데 반나절을 썼다.
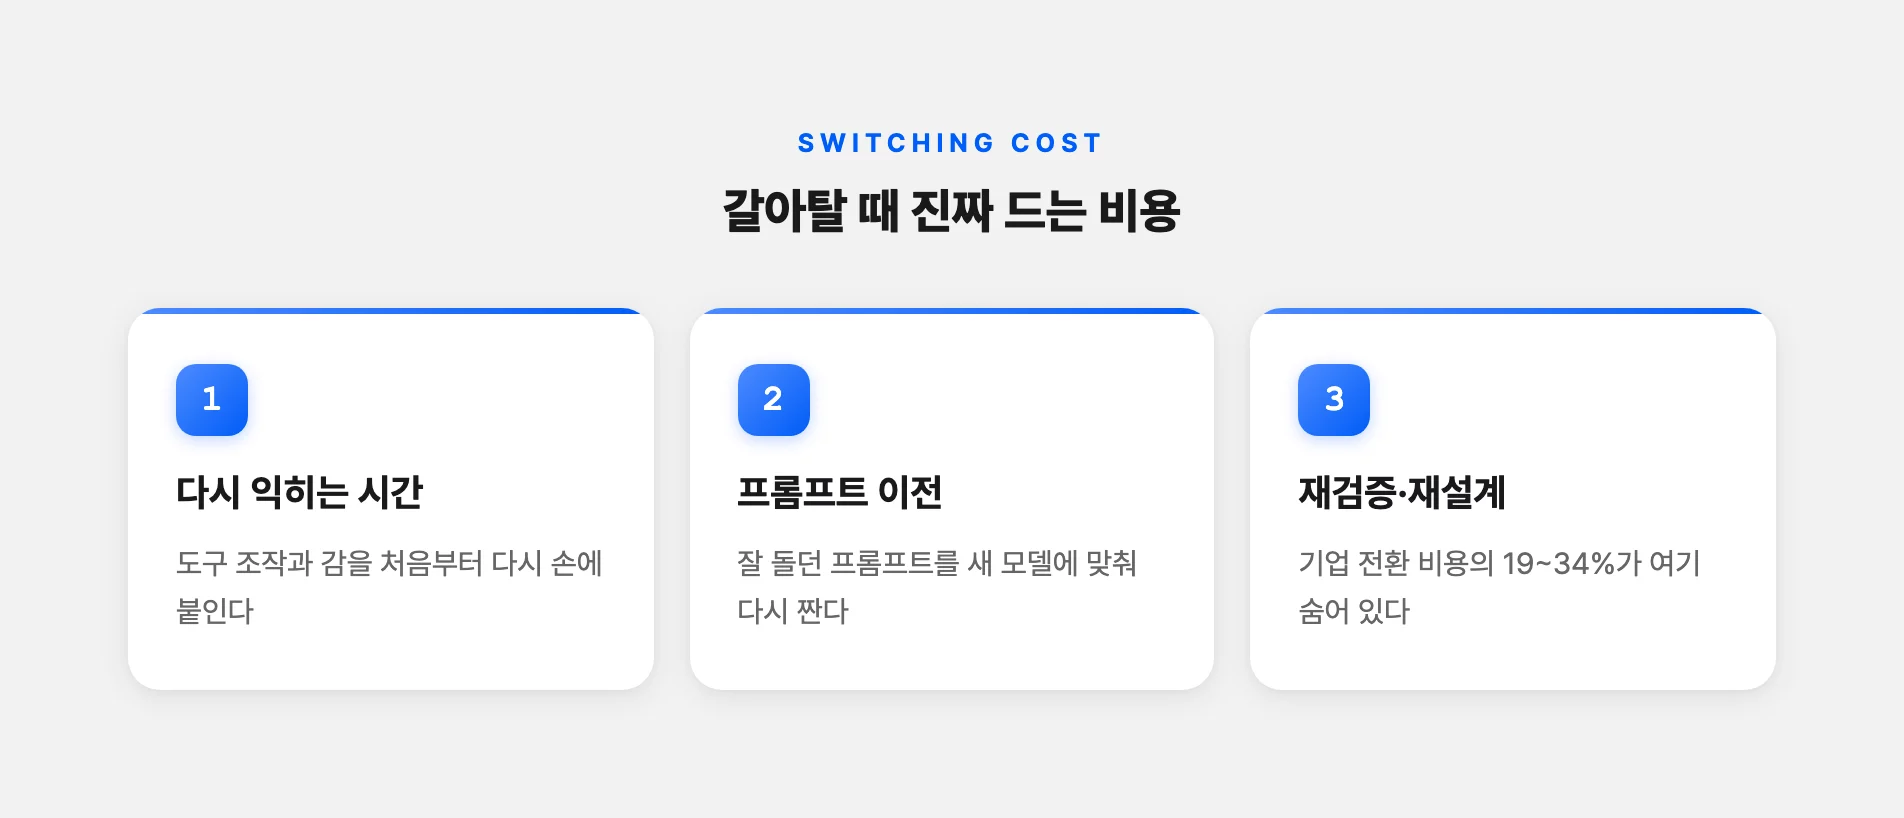
그때 알았다. 갈아타는 비용은 결제 금액이 아니었다. 도구 다시 익히고, 프롬프트 옮기고, 손에 붙은 습관을 다시 세우는 시간이 진짜 비용이었다. llm-stats.com은 이런 전환 비용이 대개 능력 차이를 넘어서고, 그 능력 차이는 다음 릴리스가 곧 지워버린다고 짚었다. 나 하나 갈아타는 데도 이런데, 조직 단위면 더 크다. 기업 사례에서 AI 벤더 전환 비용은 19~34%로 추산되는데, 진짜 비용은 기술 이전이 아니라 재교육·재검증·재설계에 숨어 있다는 거였다.
기획자 눈으로 보면 익숙한 그림이다. 화면 하나 바꾸는 것보다 그 화면에 익은 사용자 흐름을 다시 세우는 게 늘 더 비쌌다.
그래서 갈아탈지 이렇게 걸러본다
여러 자료가 반복해서 말하는 판단 규칙은 대략 비슷한 데로 모인다. 그걸 내 체크리스트로 바꿔봤다. 새 벤치마크 차트가 떴다는 이유만으로는 재검토하지 않는다는 게 핵심이다. 아래 네 가지 중 하나라도 걸릴 때만 다시 본다.
| 다시 볼 만한 신호 | 판단 기준 |
|---|---|
| 같은 품질인데 더 싸졌다 | 하던 작업을 같은 수준으로 하면서 비용이 준다 |
| 내 반복 작업에서 확실히 나아졌다 | 발표가 아니라 내가 매일 하는 일에서 눈에 띈다 |
| 우회하던 제약이 사라졌다 | 컨텍스트 한계·속도·기능 부재를 참고 있었는데 풀린다 |
| 접근 조건이 바뀐다 | 요금 인상·한도 축소·쓰던 모델 은퇴 |
반대로, 점수만 올랐고 내 작업 흐름에 닿는 변화가 없으면 그냥 넘긴다. “.5” 급 명칭 변경에 맞춰 세팅을 매주 다시 짜는 건 특히 손해다. 이번 주 최고 모델에 맞춰놓으면 몇 주 뒤 또 쌓아야 하고, 릴리스는 빠른 데다 때로는 되돌려지기까지 한다니까.
그래서 요즘은 한 번에 다 갈아타지 않는다. 주력 작업 하나에만 새 모델을 물려서 30일쯤 써본 뒤에 판단한다(bleap.finance). 대신 나만의 작은 평가 세트를 만들어뒀다. 내가 자주 하는 실제 작업 스무 개쯤을 고정 프롬프트로 즐겨찾기에 묶어두고, 새 모델이 나오면 거기에 돌려본다. 발표가 아니라 내 작업에서의 차이로 보게 되니까. 업계 흐름도 “가장 똑똑한 모델이 이긴다”에서 “가장 잘 맞는 모델이 이긴다”로 옮겨가는 중이라더라. 여러 모델을 작업별로 나눠 쓰는 모델 포트폴리오 방식 말이다. 이건 예전에 챗봇을 하나로 안 몰고 나눠 쓰는 이유를 쓰면서도 손에 잡혔던 감각이다.
가격·한도는 회사가 수시로 바꾸니까, 갈아타기 전엔 공식 페이지를 한 번 더 확인하는 게 안전하다. 이건 2026년 8월 기준으로 자료를 대조한 이야기다.
발표를 좇지 말고, 내 작업이 물어보게 하기로 했다.